Python 入門:變數、數據類型到 NumPy 與 Pandas|Quant Theory 第 9 講筆記
第 9 課・共 34 課
目錄
這是 Liu Peng 大學級量化交易課程第 9 講的筆記,屬 Python 入門教學。講者由開發環境安裝講起,依次講解變數與數據類型、運算符與控制流程、函數封裝,最後落到量化交易真正常用的兩件工具——NumPy 陣列與 Pandas 數據框,為日後處理金融數據鋪路。
學習重點
- 開發環境:Anaconda 管理套件與環境,Jupyter Notebook 以「儲存格」為單位即寫即跑;不想安裝可用 Google Colab 等雲端版本。
- 變數與數據類型:變數是記憶體中的佔位符,命名不可覆蓋內建關鍵字;常見類型包括整數、浮點數、布爾值、字串、列表、字典、ndarray 與 DataFrame。
- 控制流程與函數:
if-elif-else按條件順序評估、以四格縮進界定分支;函數把複雜邏輯封裝成黑箱,輸入與輸出皆可選。 - NumPy 陣列:一維似列表、二維是矩陣、三維以上為張量;廣播 Broadcasting 令純量與陣列自動對齊做逐元素運算。
- Pandas 數據框:處理金融數據的主力結構,
.loc按標籤、.iloc按位置選取,布林條件可做行級篩選,並支援 CSV、Excel 讀寫。
詳細筆記
開發環境:Anaconda 與 Jupyter Notebook
講者建議初學者由 Anaconda 入手——這是一套管理 Python 軟件、套件與環境的工具,按作業系統下載對應安裝程式即可。他特別提醒一個細節:安裝時應選「為整部電腦安裝」而非「僅為此用戶安裝」,否則日後安裝套件時可能因權限不足而報錯。若不想安裝任何軟件,可改用 Google Colab 等雲端 Jupyter Notebook,打開瀏覽器已能寫代碼。
講者解釋選用 Python 的原因:語法簡單、可讀性高,加上開源函數庫生態成熟,處理金融數據特別順手。至於編程環境,主力是 Jupyter Notebook(或其進階版 JupyterLab)。介面以儲存格為單位:代碼儲存格寫程式,Markdown 儲存格寫文件。講者強調,寫代碼是一回事,寫好註釋是另一回事——清晰的註解令邏輯可讀,他人(以及三個月後的自己)才看得懂。
變數與賦值
變數 Variable 是記憶體中的佔位符,用來存放數據。以賦值運算符 = 把數值放入變數:a = 10,左邊是變數名,右邊是值。賦值後的變數又稱對象 Object,自帶屬性與方法可供調用。若直接 print(10) 而不存入變數,這個 10 打印後便消失,無法再用。
講者特別示範一個陷阱:print 本身是系統內建函數,若寫 print = 5 把它當變數名,之後再調用 print(10) 便會報錯——因為 print 已不再是函數。變數命名規則:只限一個字、不可有空格;可含字母、數字與底線;不得以數字開頭;並應避開 Python 關鍵字。講者推薦初學者用 pythontutor.com 逐步追蹤代碼執行過程。
數據類型總覽
講者以一張表總結常用數據類型:
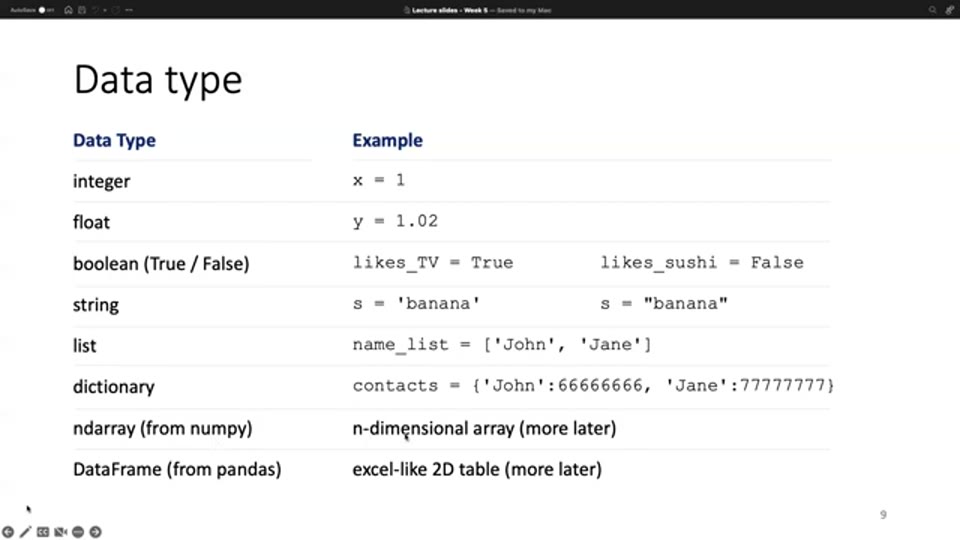
- 整數 Integer:如
x = 1。 - 浮點數 Float:帶小數的數值,如
y = 1.02。 - 布爾值 Boolean:只有 True 或 False,常用於判斷某段代碼是否執行。
- 字串 String:字符的集合,如
s = 'banana'。 - 列表 List:以方括號標識的有序容器,可放多個不同類型的元素。
- 字典 Dictionary:以花括號標識的鍵值對 Key-Value Pair 結構,講者比喻為書的索引——鍵是索引條目,值是對應頁面。
- ndarray:來自 NumPy 的 n 維陣列。
- DataFrame:來自 Pandas 的類 Excel 二維表格,講者明言這是處理金融數據的主力——直行是不同日期,橫列是不同價格欄位。
運算符:比較與邏輯
運算符 Operator 用來執行特定操作。比較運算符包括 >、<、>=、<=、==、!=,所有比較表達式的結果都是布爾值。邏輯運算符把多個條件串連:and 要求左右兩個條件同時為真才回傳真;or 只要其一為真即真;not 把結果取反。以邏輯記號表示:
這類條件判斷正是日後撰寫交易訊號(例如「價格高於某門檻且成交量放大」)的基礎。
控制流程與函數
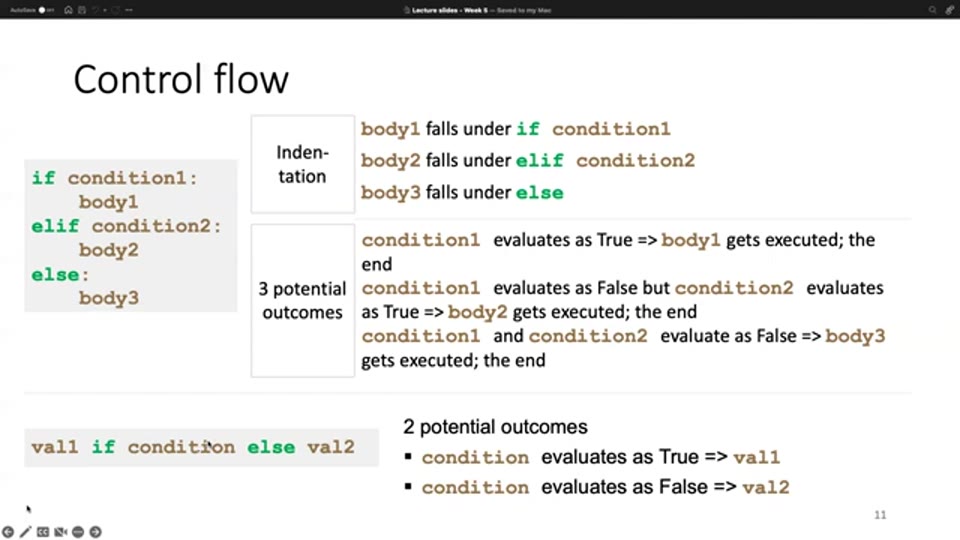
當程式需要「若此條件成立便做甲、否則做乙」,便用到控制流程 Control Flow。講者以 if-elif-else 結構示範:兩個條件、三個分支。執行是順序的——先評估條件一,成立便執行第一分支並結束;不成立才評估條件二;兩者皆假則落入 else。因此條件的先後次序本身也是設計的一部分。每個分支的主體以四格縮進 Indentation 界定,這是 Python 語法的硬性要求。只有單一條件時,可寫成一行:val1 if condition else val2,條件為真回傳 val1,否則回傳 val2。
函數 Function 是封裝的手段:當一段邏輯變得複雜,便把它包起來當黑箱調用。系統內建函數如 print(輸出訊息、無回傳值)與 type(回傳數據類型)各司其職;用戶亦可自訂函數,輸入與輸出皆屬可選。
字串、列表與字典的操作
字串是字符的集合,採零基索引 Zero-based Indexing——第一個字符的索引是 $0$ 而非 \$1$,第 $i$ 個字符寫作 $s[i-1]$。常用操作包括:len() 求長度、以冒號切片取子字串(如 s[0:3])、用 in 判斷某字串是否包含於另一字串、以 + 拼接兩個字串。
列表的存取方式與字串類似,同樣用方括號與零基索引:取第二個元素寫 list[1]。亦可求長度、切片取連續元素、用 in 判斷元素是否存在,以及用 append 擴充列表。字典則沒有順序概念,一律以鍵取值:contacts['John'] 回傳對應的值。對現有的鍵賦新值會覆蓋舊值;若鍵不存在,則自動新增一個鍵值對——更新與新增是同一個語法。
NumPy 陣列與廣播機制
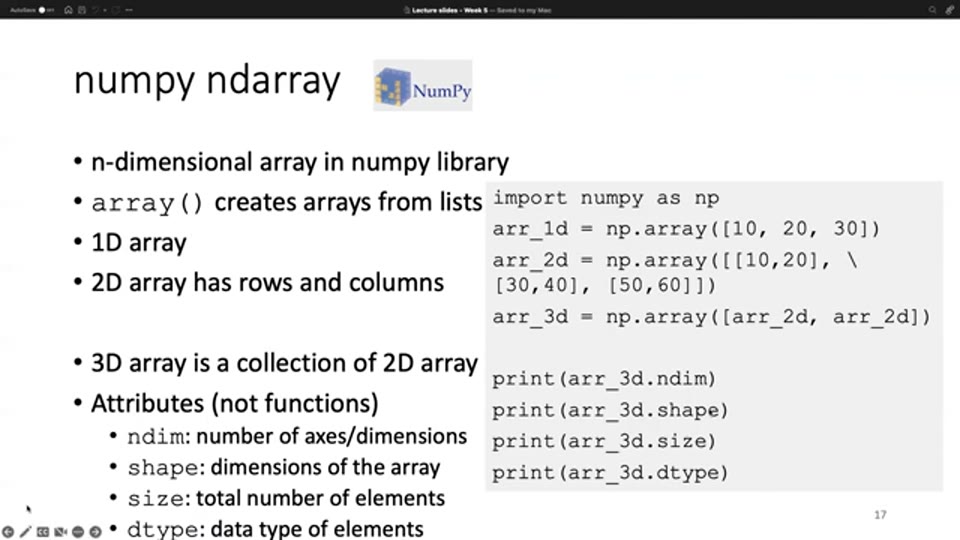
進入套件部分。安裝套件可用 pip install,或在 Anaconda 介面點按安裝;使用前必須先 import,習慣上給 NumPy 起別名 np。NumPy 的核心是 n 維陣列 ndarray:一維陣列由一層列表轉成,二維是多個列表排成矩陣,三維則是把二維陣列再疊一層,維度可繼續向上。以下代碼摘自原片教學:
import numpy as np                      # 摘錄自原片教學
arr_1d = np.array([10, 20, 30])
arr_2d = np.array([[10, 20], [30, 40], [50, 60]])
print(arr_2d.ndim)   # 維度數
print(arr_2d.shape)  # 各維度長度
print(arr_2d.size)   # 元素總數
陣列附帶 ndim(維度數)、shape(形狀)、size(元素總數)、dtype(元素類型)等屬性可查閱。元素存取與列表類似,按維度傳入多個索引;內建函數可直接計均值 $\bar{x} = \dfrac{1}{n}\sum_{i=1}^{n} x_i$、最大值、標準差、百分位數等統計量——留意有 NumPy 函數與對象方法兩種調用方式。
NumPy 的另一重點是逐元素運算 Element-wise Operation 與廣播 Broadcasting。對陣列寫 arr + 10,系統先把 10 廣播成與陣列同形的 $[10, 10, 10]$,再逐元素相加,效果等同 $c_i = a_i + 10$。講者提醒:廣播並非每次都行得通,例如二維陣列加一維陣列時,系統會沿垂直軸複製後者再相加,動手前必須確認維度相容。
Pandas Series 與 DataFrame
Pandas 的 Series 可視為表格中的一列,由列表或陣列建成,附帶索引與值兩部分——索引預設是整數,處理時間序列時可換成日期,值則是對應的價格。存取元素有兩套邏輯:按位置(position-based)與按標籤(label-based)。
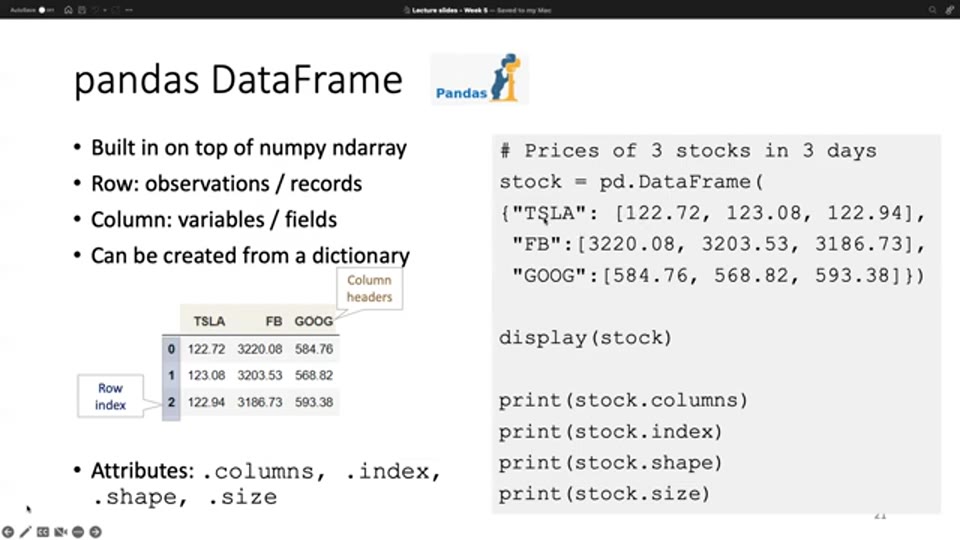
DataFrame 是建於 ndarray 之上的二維表格:行是觀察記錄、列是變數欄位。最簡單的建立方法是先組織一個字典,再轉換成數據框。以下代碼摘自原片教學:
stock = pd.DataFrame({                   # 摘錄自原片教學
    "TSLA": [122.72, 123.08, 122.94],
    "FB":   [3220.08, 3203.53, 3186.73],
    "GOOG": [584.76, 568.82, 593.38]})
print(stock.columns)  # 欄名
print(stock.shape)    # 維度
數據框附帶 .columns、.index、.shape、.size 等屬性;索引可如 Series 般覆寫。取單列直接傳欄名,取多列則把欄名包成列表再傳入。
更常用的是 .loc 與 .iloc 兩個屬性:.loc 按標籤選取——例如指定某個日期索引的行、某個名為 TSLA 的列,亦可同時選多日多列;.iloc 的 i 代表 index,按位置選取——傳入 1 即第二行或第二列,毋須理會標籤是甚麼。
條件篩選與檔案讀寫
講者最後示範布林篩選 Boolean Indexing:先寫一個條件(例如特斯拉股價高於某門檻),會得到一列 True/False;把這個條件傳入 .loc,系統便只回傳符合條件的行,完成行級篩選。多個條件可用邏輯運算符 &(and)、|(or)、~(not)組合。講者補充一個小語法:當一行代碼過長,可用反斜線 \ 換行,告訴 Python 這仍是同一行。
檔案讀寫方面,讀入數據用 read_csv、read_excel 等函數,可指定哪一欄作索引,並留意不同作業系統的檔案路徑寫法;處理完畢後用 to_csv 存檔——講者建議保留一份清洗好的乾淨數據,供下游分析直接調用,省卻每次重複清洗。
🙏 覺得內容有用?本站所有內容免費提供,使用推薦碼開戶就是支持我們繼續營運的最大鼓勵:
ZA Bank 邀請碼 P20923
—— 你享 HKD 2,000 迎新獎賞,本站獲得營運支持。
立即開戶 →
(聯盟連結|投資涉及風險,受條款及細則約束,此資料僅可於香港境內分發)
欣利克的看法
- 概念釐清:Python 是工具,不是策略本身。本講教的數據類型、控制流程、套件操作,全部屬於「把想法變成可執行代碼」的基本功。懂得寫
df.loc[df["TSLA"] > 200]不代表知道這個門檻是否合理——條件的經濟含義永遠比語法重要,初學者宜分清「會寫」與「寫得對」是兩回事。 - 常見誤區:零基索引與覆蓋內建函數是新手兩大絆腳石。講者示範的
print = 5例子看似瑣碎,實際上初學者用list、type等作變數名而弄壞程式的情況極常見;同樣,列表「第二個元素是 index 1」的零基邏輯若不內化,日後切片與.iloc選取時會不斷差一格。 - 觀點比較:本地 Anaconda 與雲端 Colab 各有取捨。講者並列兩條路:Anaconda 控制度高、數據留在本機,但要處理安裝與權限問題;Colab 免除安裝、開瀏覽器即用,惟數據需上傳雲端、免費算力有限。做敏感或大型數據分析時,本地環境仍較穩妥;快速試驗則雲端方便。
- 時效提醒:套件介面與範例數據會過時。原片於 2023 年初上載,當中「FB」代碼其後已改為 META,套件版本亦持續更新——截至 2026 年中,Pandas 部分舊語法已被淘汰。跟着舊教學實作時遇上報錯,先查閱官方文件確認語法是否仍然有效。
名詞解釋
- Python 程式語言 Python:量化交易主流編程語言,語法簡潔、開源生態成熟,適合數據處理與策略研究。
- Jupyter 筆記本 Jupyter Notebook:以儲存格為單位的互動式編程環境,代碼與說明文件並存,即寫即跑。
- NumPy 陣列套件 NumPy:提供 n 維陣列與向量化運算的數值計算核心套件,廣播機制令逐元素運算毋須寫迴圈。
- Pandas 數據套件 Pandas:建於 NumPy 之上的數據分析套件,以 Series 與 DataFrame 處理時間序列與表格數據。
- 數據框 DataFrame:Pandas 的二維表格結構,行為記錄、列為欄位,是處理金融數據的主要載體。
常見問題 FAQ
學量化交易一定要先學 Python 嗎?
不一定,但 Python 是現時最主流的選擇。講者解釋,原因在於語法簡單易讀,加上 NumPy、Pandas 等開源套件生態成熟,處理金融數據特別方便。市場上亦有 R、MATLAB、MQL5 等替代方案,惟論社羣資源與教學材料,Python 對初學者最友善。
Jupyter Notebook 與一般 Python 腳本有甚麼分別?
Jupyter Notebook 以儲存格為單位,可以逐格執行、即時看到中間結果,並夾雜 Markdown 說明文件,適合探索式分析與教學;一般 .py 腳本則由頭到尾順序執行,適合正式、需重複運行的程式。講者提醒,筆記本儲存格可亂序執行,依賴變數狀態時要格外留神。
NumPy 陣列與 Python 列表有甚麼分別?
列表是 Python 內建的通用容器,可混合存放不同類型;NumPy 陣列則專為數值計算而設,支援多維結構、向量化運算與廣播機制,整列數據一次過運算,速度遠勝以迴圈逐個處理列表。處理大規模金融數據時,陣列是標準做法。
.loc 與 .iloc 如何分辨?
.loc 按標籤選取:傳入的是索引的名稱,例如某個日期或欄名 TSLA。.iloc 按位置選取:傳入的是整數位置,例如 1 代表第二行或第二列,與標籤內容無關。記憶口訣是 i 代表 index(整數位置)。兩者皆可同時選取多行多列,是數據框切片的主力工具。
原影片
本文整理自以下影片,版權屬原創作者所有,建議配合原片觀看: