對數回報實作:Lab 1 用 Python 計算累積回報|Quant Theory Lab 筆記
第 18 課・共 34 課
目錄
這是 Liu Peng 大學級量化交易課程第一個 lab 的實作筆記,主題是對數回報 Log Return 的 Python 實作。講者在 Google Colab 上即場寫 code,用 yfinance 下載 Google 股價,把第 10 講推導過的三種累積回報算法逐行實現,並用程式驗證三者結果完全一致。
學習重點
- 數據準備:用 yfinance 下載 GOOG 股價,回傳以日期為索引的 DataFrame;指定日期範圍不代表每日都有數據,只有交易日才有記錄。
- 單期回報:對收市價序列應用
pct_change()即得簡單回報 Simple Return;第一期必為空值(NaN),因為沒有前期價格可比較。 - 終值回報:期末價除以期初價再減 1,本 lab 的示範結果約 $-1.72\%$。
- 累積回報兩算法:簡單回報轉 1+R 格式後用
cumprod()連乘;對數回報則用cumsum()連加再取指數——兩者最後一期數值與終值回報完全相等。 - 化乘法為加法:對數性質 $\ln(AB) = \ln A + \ln B$ 是整個 lab 的數學核心,令累積運算由連乘變連加。
詳細筆記
Lab 環境與數據準備
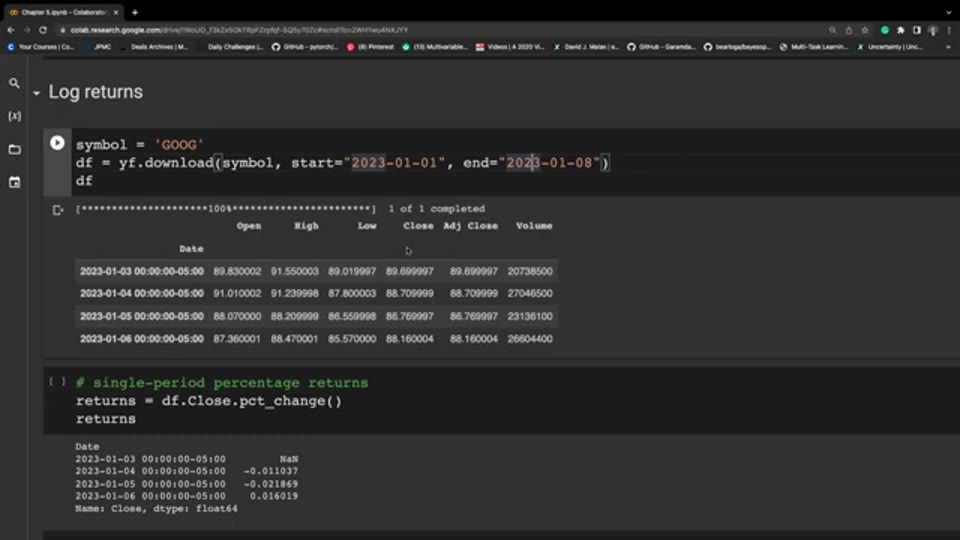
講者在 Google Colab 的 Jupyter Notebook 環境中示範,整個 lab 以儲存格(cell)為單位逐段執行。第一步是取得數據:用 yfinance 套件下載 Google(GOOG)的股票數據,日期範圍設為 2023 年 1 月 1 日至 1 月 8 日。
symbol = 'GOOG'
df = yf.download(symbol, start="2023-01-01", end="2023-01-08")
df
(以上 code 摘錄自原片教學)
執行後可見一個重要細節:雖然指定了八天的範圍,回傳的 DataFrame 只有四行——2023 年 1 月 3 日至 6 日。原因是 1 月 1 日與 2 日是週末及假期,並非交易日,自然沒有數據。這提醒初學者:日期範圍是查詢條件,不是結果保證,實際行數取決於交易日曆。
數據結構方面,日期被設為索引(index),欄位共六個:開市價(Open)、最高價(High)、最低價(Low)、收市價(Close)、調整後收市價(Adj Close)與成交量(Volume)。本 lab 全程只用 Close 一欄,即每個交易日的收市價。
步驟一:pct_change 計算單期簡單回報
取得價格序列後,講者先計算每個交易日的單期回報。pandas 的 Series 自帶百分比變化函數 pct_change(),對序列應用此方法,會回傳一條索引相同的新序列,每個數值是當期相對前期的百分比變化:
這就是簡單回報 Simple Return,又稱百分比回報。以第二個交易日為例,函數取當日收市價減去前一日收市價,再除以前一日收市價,得出相對前一交易日的百分比變化。
# single-period percentage returns
returns = df.Close.pct_change()
returns
(以上 code 摘錄自原片教學)
輸出中第一期的值是 NaN(空值)。原因很直接:第一個交易日之前沒有價格點,無法計算差值,函數只能留空。這個 NaN 在後續計算會自動被累積函數略過,但實作時要意識到它的存在——例如計算平均回報前,通常要先移除空值,否則部分統計函數會回傳 NaN。
至此得到的 returns 序列,每一項代表該交易日的單日回報,每日數值各自獨立。問題來了:如果期初手持一股(示範中約 89 美元),持有到期末,整段期間的回報是多少?
步驟二:首尾價格法計終值回報
終值回報 Terminal Return 問的是:由期初持有到期末,總共經歷了幾多百分比的變化?最直接的算法只需兩個價格點——期末收市價除以期初收市價,再減 1:
$$R_{0,T} = \frac{P_T}{P_0} - 1$$其中 $P_T / P_0$ 是 1+R 格式,代表期末資產相對期初本金的倍數;減 1 是把倍數還原成回報率。示範中該週股價下跌,算出的終值回報約為 $-1.72\%$,即持倉價值縮水了約 1.7%。價格跌,回報是負數,方向與價格變動一致。
這個方法勝在直觀,只需首尾兩個數據點;缺點是完全忽略了中間交易日的價格資訊,看不到資金在期間內的升跌軌跡。
步驟三:cumprod 累積回報與交叉驗證
第二種方法把終值回報視為複利 Compounding 過程:每日的回報連本帶利滾入下一日,逐日複利累積。程式上先把簡單回報轉成 1+R 格式(每項代表當日資金的倍數變化),再應用累積乘積函數 cumprod():
cumprod() 的「累積」是指:每一期的輸出值,等於由期初到當期所有 $(1+R_i)$ 的連乘積。最後再減 1,還原成簡單回報口徑的累積回報 Cumulative Return。
# cumulative returns
cum_returns = (1+returns).cumprod() - 1
cum_returns
(以上 code 摘錄自原片教學)
與首尾價格法不同,cumprod 輸出的是一條完整序列:每一期都顯示由期初持有到該日的累積回報,可以看見資金中間的演變,而非只看終點。
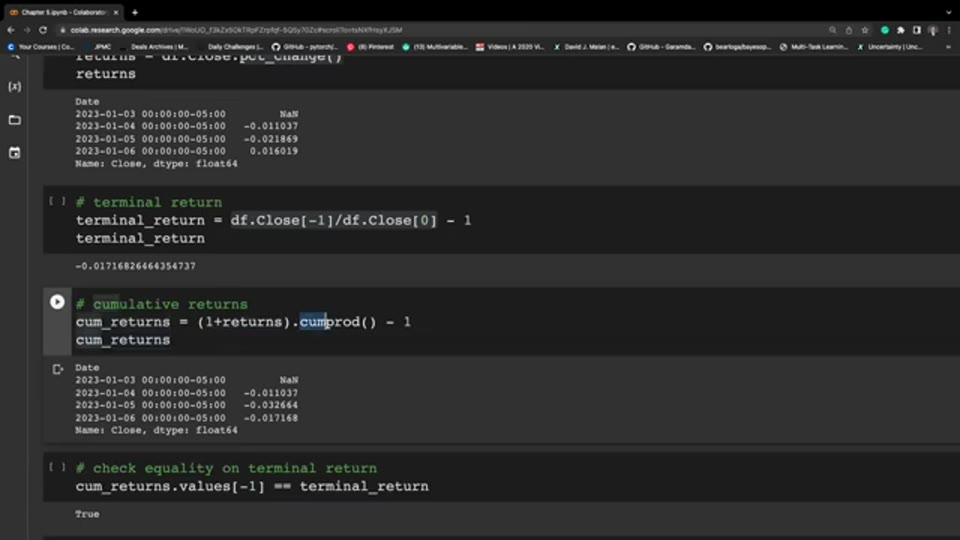
接着講者做了一件值得學習的事——交叉驗證。他用 cum_returns.values[-1] 取出累積回報序列的最後一項(.values 屬性會捨棄索引、只取數值本身),與步驟二首尾價格法算出的終值回報比較,結果回傳 True:兩條路徑抵達同一終點。這與回報與風險的基礎計算|第 7 課的推導一致:多期回報連乘後,中間項全部對銷,理論上只剩 $P_T / P_0$。實作時養成「用兩種方法算同一樣東西、再驗證相等」的習慣,是發現 code 錯誤的有效手段。
步驟四:對數回報、cumsum 與化乘法為加法
第三種方法輪到本 lab 的主角登場。把 1+R 格式的單期回報取自然對數,就得到對數回報 Log Return:
$$r_t = \ln(1 + R_t) = \ln\left(\frac{P_t}{P_{t-1}}\right)$$程式上用 NumPy 的 np.log() 對整條序列做變換。關鍵分別在下一步:原本簡單回報要用 cumprod() 連乘,對數回報改用 cumsum() 連加,最後以指數函數 np.exp() 還原、再減 1:
# log returns (1+R format)
log_returns = np.log(1+returns)
# get cumulative returns using log returns
cum_return2 = np.exp(log_returns.cumsum()) - 1
(以上 code 摘錄自原片教學)
為何乘法可以變加法?講者在畫面上即場手寫推導:設兩個 1+R 格式的數量 $A$ 與 $B$,原本要計算乘積 $A \cdot B$;取對數後,利用對數函數的基本性質,乘積變成求和:
$$\ln(A \cdot B) = \ln A + \ln B$$求和完畢,再施加指數變換——指數函數是對數函數的逆運算,正好把對數變換「對銷」,還原出原來的乘積:
$$\exp(\ln A + \ln B) = \exp(\ln(A \cdot B)) = A \cdot B$$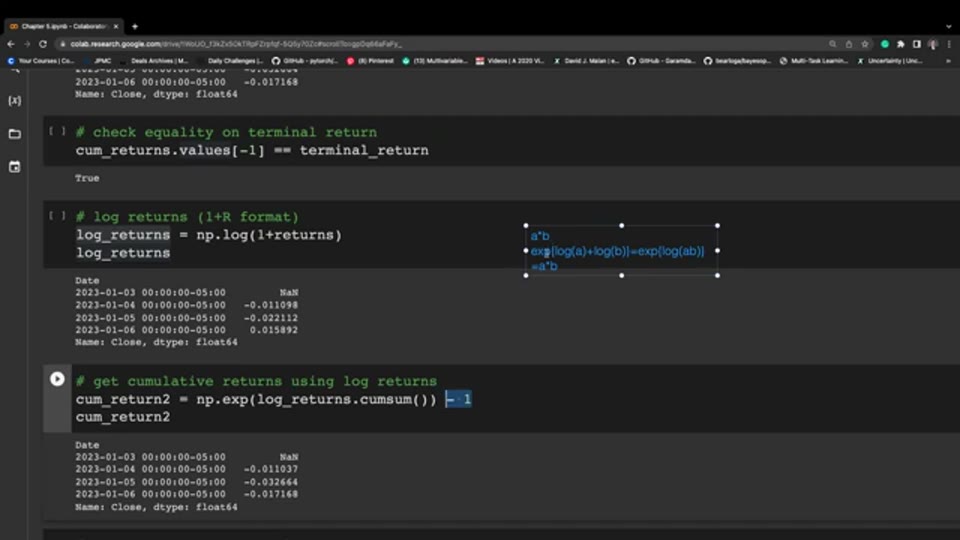
換言之,整條路徑是「取對數 → 連加 → 取指數 → 減 1」,兜了一個圈,計算的仍是同一樣東西。講者再次交叉驗證:取 cum_return2 的最後一項與終值回報比較,結果同樣相等。三種算法——首尾價格法、cumprod 連乘法、對數回報 cumsum 法——殊途同歸。
那為何要兜這個圈?講者點明:連乘在數學推導上很難處理,加法比乘法容易操作得多。把問題轉到對數空間,累積運算由 cumprod 變 cumsum,之後做統計分析(均值、方差、回歸)都建基於可加變量,推導順暢;需要實際回報數字時,取指數轉回原來尺度即可。這正是第 10 講強調對數回報是量化研究標準口徑的原因,本 lab 則用 code 把這個抽象優點變成可以親手執行的具體操作。
Lab 總結:三條路徑一個終點
回顧整個 lab 的流程:下載數據 → 計算單期簡單回報 → 分別用三種方法計算累積與終值回報 → 逐項驗證相等。技術細節之外,有兩個實作態度值得記下。其一,每個新函數都要看清輸出結構:pct_change() 保留原索引、第一期留 NaN;cumprod() 與 cumsum() 輸出完整序列而非單一數值;.values 捨棄索引只取數值。其二,結果要用獨立方法驗證:講者三次使用相等性檢查(回傳 True),確認不同算法的輸出一致,這種「自己考自己」的習慣,在日後策略回測中會救回無數隱藏錯誤。
🙏 覺得內容有用?本站所有內容免費提供,使用推薦碼開戶就是支持我們繼續營運的最大鼓勵:
ZA Bank 邀請碼 P20923
—— 你享 HKD 2,000 迎新獎賞,本站獲得營運支持。
立即開戶 →
(聯盟連結|投資涉及風險,受條款及細則約束,此資料僅可於香港境內分發)
欣利克的看法
- 概念釐清:三種算法是同一數學事實的三種寫法,不是三個答案。初學者容易以為 cumprod 與 cumsum 版本「近似相等」,其實在忽略浮點誤差的前提下,三者是嚴格相等的——這正是講者用
==驗證回傳 True 的原因。分別只在計算路徑與後續分析的便利性:要做統計建模,對數回報的加法結構無可替代;只問持有期間總回報,首尾價格法一行已夠。 - 常見誤區:忽略 pct_change 留下的 NaN。第一期的空值不是程式錯誤,而是「沒有前期可比」的自然結果。但 NaN 會向下游傳染:直接對含 NaN 的序列求平均或標準差,結果會是 NaN。實作時應養成習慣,計算統計量前先
dropna(),或確認所用函數會自動略過空值——cumprod 與 cumsum 會保留 NaN 位置但跳過計算,行為並不一致,動手前要查清文件。 - 觀點比較:簡單回報與對數回報各有管轄範圍。本 lab 展示了兩者在時間維度上可以互相轉換,但第 10 講已提過一個重要例外:計算投資組合的橫切面加權回報時,只有簡單回報正確,因為組合回報等於各資產簡單回報的加權平均,對數回報沒有這個性質。時間序列分析用對數回報、組合橫切面用簡單回報,是教科書的標準分工,混用是回測中常見的隱藏錯誤。
- 時效提醒:免費數據接口並非一成不變。原片於 2023 年上載,yfinance 回傳的欄位結構(例如是否多層索引、Adj Close 欄位是否存在)在近年版本更新中已有變化。截至 2026 年中,照抄原片 code 在新版套件下未必能原樣運行,實作時應先印出
df.columns檢查結構,再決定取欄位的寫法。
名詞解釋
- 對數回報 Log Return:取 1+R 格式回報的自然對數,具時間可加性,多期累積由連乘化簡為連加,是量化研究的標準回報口徑。
- 簡單回報 Simple Return:現價減前價再除以前價的百分比回報,單期直觀但多期須連乘,不可直接相加。
- yfinance 股價數據套件 yfinance:Python 的免費金融數據套件,從 Yahoo Finance 下載歷史價量數據並回傳 DataFrame。
- Pandas 數據套件 Pandas:建基於 NumPy 的數據分析函數庫,以 Series 與 DataFrame 處理時間序列,本 lab 的 pct_change、cumprod、cumsum 皆為其 Series 方法。
- NumPy 陣列套件 NumPy:Python 數值計算核心套件,提供向量化運算,本 lab 用其 np.log 與 np.exp 做對數與指數變換。
- 數據框 DataFrame:Pandas 的二維表格結構,行為日期、列為價量欄位,是 yfinance 回傳數據的載體。
- 複利 Compounding:每期回報連本帶利滾存再投資,多期回報以累乘計算,是 cumprod 算法背後的經濟含義。
常見問題 FAQ
pct_change 計算出來的第一期為何是 NaN?
因為第一個交易日之前沒有價格點,無法計算「相對前期」的百分比變化,函數只能留空。這是正常行為而非錯誤;但後續計算統計量前應先移除空值,避免 NaN 向下游傳染。
cumprod 與 cumsum 算出的累積回報真的完全一樣嗎?
在數學上嚴格相等:由對數性質 $\ln(AB) = \ln A + \ln B$,連乘取對數後變連加,再取指數還原,結果與直接連乘相同。講者在原片以相等性檢查驗證兩者最後一期數值一致,回傳 True。
既然首尾價格相除一行就能算出終值回報,為何還要學對數回報?
首尾價格法只用兩個數據點,看不到中間軌跡,也無法做統計分析。對數回報把多期累積化為加法,均值、方差、回歸等分析工具才能順暢應用——這是量化研究普遍採用對數回報的根本原因,詳見第 10 講。
yfinance 下載的日期範圍內,為何不是每日都有數據?
因為只有交易日才有價格記錄。週末與公眾假期休市,指定日期範圍只是查詢條件;原片示範下載 2023 年 1 月 1 日至 8 日的數據,實際只得 1 月 3 日至 6 日共四行。
原影片
本文整理自以下影片,版權屬原創作者所有,建議配合原片觀看: