Lab 2 實作:SMA 與 EMA 平滑均線的 Python 實戰|Quant Theory 第 19 講筆記
第 19 課・共 34 課
目錄
這是 Liu Peng 大學級量化交易課程第二個實作 lab 的筆記,主題是以 Python 實作簡單移動平均線 SMA 與指數移動平均線 EMA。兩條均線的公式推導與平滑原理,第 11 講已有完整講解(詳見移動平均線與雙均線趨勢跟隨策略|第 11 課);本 lab 把理論落地:用 yfinance 下載蘋果公司(AAPL)2022 年起的日線數據,以 pandas 的 rolling 與 ewm 函數分別計算兩種均線,並逐步驗證結果。
學習重點
- 數據準備的關鍵一步:yfinance 下載後把索引轉為 datetime 格式,pandas 繪圖時才能識別時間軸,自動把刻度聚合到月份層級。
- SMA 用
rolling(window).mean():窗口內等權重平均,期初不足一個窗口的位置預設為 NaN;設min_periods=1可「有多少用多少」。 - EMA 用
ewm(alpha, adjust=False).mean():不需指定窗口,全部歷史數據納入計算,權重按 $(1-\alpha)$ 指數衰減。 - 驗證是實作的一部分:手動計算序列首幾個值,與函數輸出對照,確認參數設定與預期一致。
- 參數即取捨:窗口小或 $\alpha$ 大,曲線貼近價格;窗口大或 $\alpha$ 小,曲線平滑但反應變慢。
詳細筆記
數據準備:yfinance 下載與日期索引
講者先用 yfinance 下載蘋果公司的日線數據,範圍由 2022 年 1 月初至 2023 年初,約一年的交易日數據。下載所得是一個 pandas DataFrame,包含開市、最高、最低、收市、調整後收市價 Adjusted Close 與成交量六欄,與一般行情軟件的 OHLCV 結構一致。
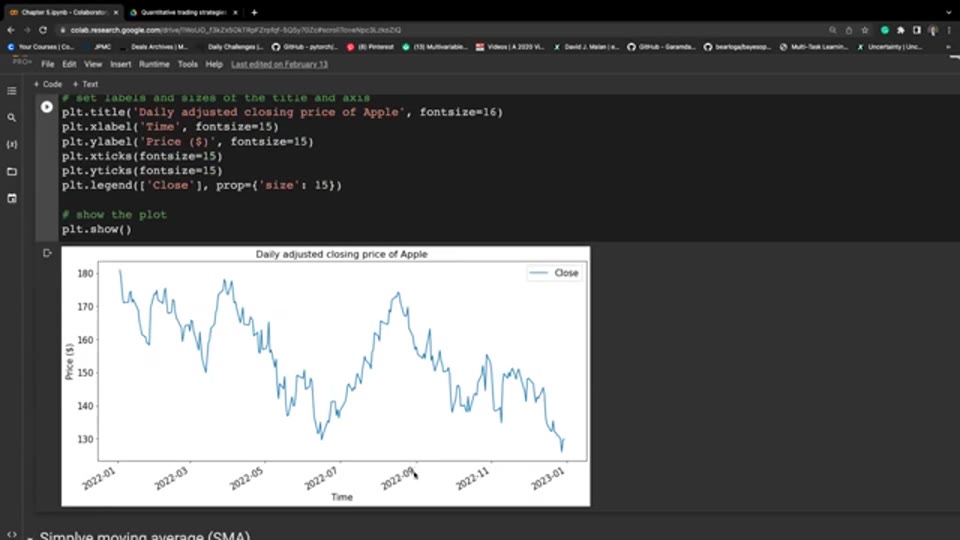
下載後有一個容易忽略但十分重要的步驟:把 DataFrame 的索引轉換為 datetime 格式。yfinance 回傳的索引預設未必是標準日期時間型態;講者指出,轉換之後 pandas 才「聰明」到能識別索引是日期,繪圖時自動把時間軸聚合到月份層級,圖表刻度才會顯示為 2022-01、2022-03 等月份標籤,而不是逐日擠滿整條橫軸。這一步不改變任何數據,純粹是讓後續的視覺化與時間序列操作能正確運作。
其後的分析只聚焦調整後收市價一欄——均線一般以收市價為輸入,而調整後收市價已剔除拆股、股息等公司行動造成的跳空,是量化計算的標準選擇。把它繪出來,可見 AAPL 在該年內由約 180 美元水平反覆回落至 130 美元附近,途中多次急升急跌——這正是需要用均線平滑的典型序列:長線方向被大量短期噪音遮蔽,肉眼難以判讀趨勢。
SMA 實作:rolling 加 mean
簡單移動平均線的定義,是當期連同過去 $M-1$ 期價格的等權重平均:
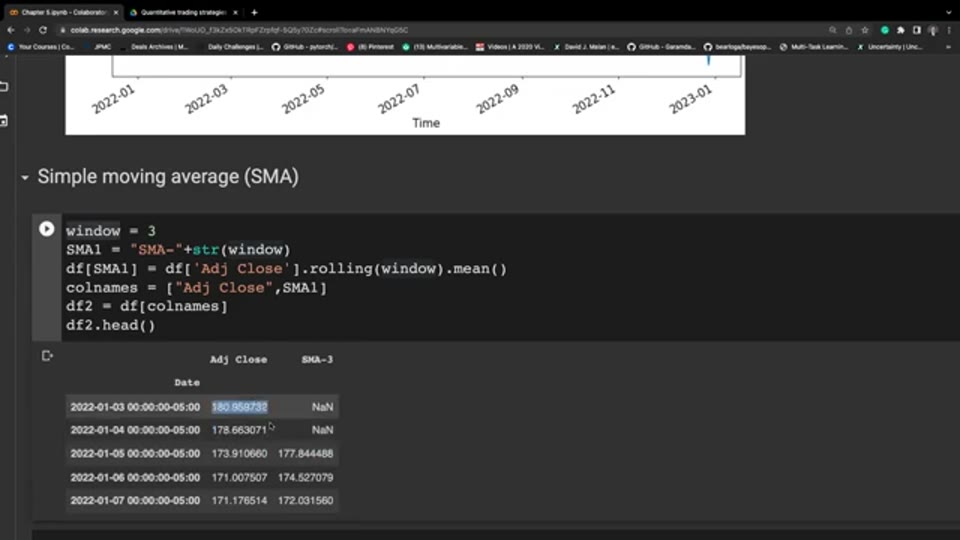
$$\mathrm{SMA}_t = \frac{S_{t-(M-1)} + \cdots + S_{t-1} + S_t}{M}$$程式層面,pandas 的 rolling 方法把窗口沿序列逐期滾動,再套 mean 對每個窗口求平均。講者以窗口 3 為例:先指定 window = 3,再動態拼出新欄名稱 SMA-3——欄名跟着窗口大小走,日後改參數時不用手動改名。新欄每個值是當期連同前兩期收市價的平均:窗口框住該行及之前兩行共三個數據點,取其均值作為該行的均線值。最後把調整後收市價與新均線兩欄抽出,組成新的 DataFrame 展示:
# 摘錄自原片教學
window = 3
SMA1 = "SMA-" + str(window)
df[SMA1] = df['Adj Close'].rolling(window).mean()
colnames = ["Adj Close", SMA1]
df2 = df[colnames]
df2.head()
輸出的表格清楚顯示:首兩行的 SMA-3 是 NaN,因為第一、二期之前沒有足夠歷史數據填滿窗口——窗口要求三個點,期初只有一兩個點可用,平均值在定義上不存在。由第三期起,窗口首次填滿,均線開始有值。
講者即場做驗證:取出調整後收市價的首三個值手動求平均,結果與第三行的 SMA-3 完全一致(約 177.84),證明 rolling 的計算邏輯正確。這種「用函數算出來,再手動驗算首幾個值」的習慣,貫穿整個 lab——函數是黑盒,只有對照過定義,才能確定參數沒有用錯。
min_periods:期初空值的處理
首兩行的 NaN 代表「窗口尚未填滿」,在後續計算中不可用。講者示範,若想在期初「有多少用多少」,可以放寬要求:在 rolling 中加入 min_periods=1,意思是窗口內只要至少有一個數據就計算,不再堅持填滿整個窗口。
效果立竿見影:第一行的窗口只有一個值,平均值等於價格本身;第二行的窗口有兩個值,均線是首兩個價格的平均;第三期起窗口填滿,回復正常的三期平均。這是實作上對初始值的特殊處理,用處是保留期初數據供後續運算——例如序列較短時,丟掉期初十幾行可能損失可觀的樣本。但講者也提示了代價:這些期初值只由一至兩個數據點構成,平均的統計基礎薄弱,平滑效果近乎沒有,解讀時要留意。
窗口大小的平滑效果對比
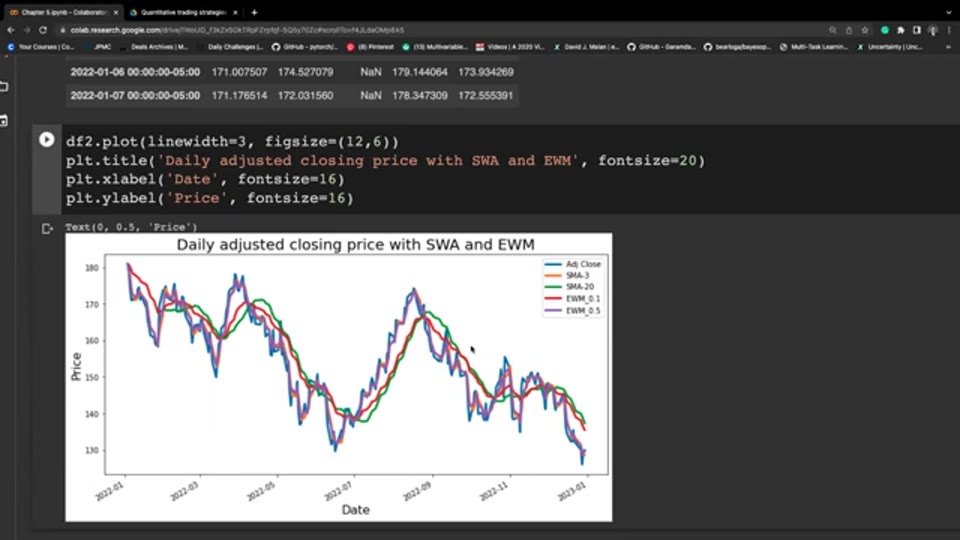
講者接着比較兩條 SMA,把平滑效果視覺化。先看 SMA-3:紅線疊加在原價格上幾乎形影不離,走勢緊貼價格,仍保留大量短期上落——窗口只有三期,平均效應有限,平滑作用僅止於削去最極端的單日跳動。
把窗口加大到 20,畫面截然不同。SMA-20 每個點都要動用過去 20 期價格取平均,單日的大升大跌被其餘 19 期攤薄,短期震盪大幅消減,曲線明顯圓滑,只餘中期走向。這正正印證第 11 講的推導:平滑程度與反應速度是一對取捨——窗口越長,曲線越平滑,對最新價格變化的反應也越慢;窗口越短,反應越快,但均線與原價格分別不大,失去平滑意義。
EMA 實作:ewm 與 alpha
指數移動平均線的遞推定義是:
$$\mathrm{EMA}_t = \alpha S_t + (1-\alpha)\,\mathrm{EMA}_{t-1}$$當期值佔權重 $\alpha$,過去的運行均值佔 $(1-\alpha)$——本質是當期觀測與歷史記憶之間的權衡。把遞推逐層展開,可見所有歷史數據點都納入計算,只是權重按幾何級數遞減:
$$\mathrm{EMA}_t = \alpha\left[S_t + (1-\alpha)S_{t-1} + (1-\alpha)^2 S_{t-2} + \cdots\right]$$講者強調,EMA 沒有明確的窗口設定:越遠的歷史數據權重越小,呈指數式衰減,但理論上永不為零。這與 SMA 的「窗口之內等權、窗口之外歸零」形成鮮明對比。
實作上用 pandas 的 ewm(exponentially weighted moving)函數。這個函數有多個參數可調——例如可以改用窗口長度(span)或半衰期(halflife)取代 $\alpha$ 來定義權重——而為了完全對應第 11 講的遞推公式,講者選擇直接指定 $\alpha$,並設定 adjust=False:
# 摘錄自原片教學
alpha = 0.1
df2['EWM_' + str(alpha)] = df2['Adj Close'].ewm(alpha=alpha, adjust=False).mean()
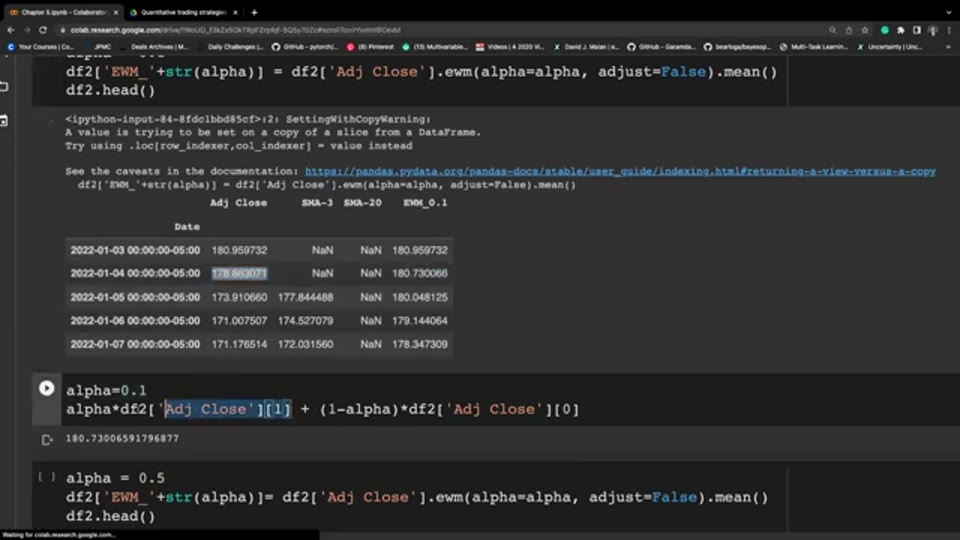
與 SMA 不同,EMA 的輸出由第一期起已有數值——因為它動用全部歷史數據而非固定窗口,期初不存在「窗口未填滿」的問題,第一期的 EMA 就是價格本身。
講者同樣即場驗證:以 $\alpha=0.1$ 手動計算第二期的值,即 $0.1$ 乘第二期收市價加上 \$0.9$ 乘第一期收市價,得出約 180.73,與 ewm 輸出的第二期完全一致。換言之,遞推公式、手算結果與函數輸出三方對照無誤,才算真正完成這一步實作。
參數對比與策略預告
調整 $\alpha$ 可產生不同的權重方案。講者再算一條 $\alpha=0.5$ 的 EMA:一半權重給當期價格,一半給歷史均值。他用同一個驗證方法核對過新序列的數值,確認無誤才繼續。這條 EWM-0.5 的曲線自然緊貼價格,是圖中與原價格最貼近的一條平滑線;$\alpha=0.1$ 則把九成權重交給歷史均值,平滑得多,滯後也更明顯。
最後把原價格、SMA-3、SMA-20 與兩條 EMA 同圖繪出。五條曲線並排,參數規格與平滑程度的關係一目了然:貼近價格的一端是 SMA-3 與 EWM-0.5,平滑的一端是 SMA-20 與 EWM-0.1。不同參數、不同權重方案,得出的平滑曲線就不同——沒有哪一條「最正確」,只有哪一條最配合分析目的。
講者在結尾預告:這些平滑曲線會進入日後的策略構建部分——取兩條平滑曲線,當兩線出現交叉 Crossover 時產生交易訊號,並按訊號執行交易動作。本 lab 計算均線的功夫,正是為那一刻鋪路;屆時快線與慢線的選擇,就是今天比較過的各種參數組合。
🙏 覺得內容有用?本站所有內容免費提供,使用推薦碼開戶就是支持我們繼續營運的最大鼓勵:
ZA Bank 邀請碼 P20923
—— 你享 HKD 2,000 迎新獎賞,本站獲得營運支持。
立即開戶 →
(聯盟連結|投資涉及風險,受條款及細則約束,此資料僅可於香港境內分發)
欣利克的看法
- 「adjust=False」才是課堂公式:pandas 的
ewm預設adjust=True,會把整條序列的加權平均重新歸一化,數值與遞推定義不同。若想重現教科書的 $\mathrm{EMA}_t = \alpha S_t + (1-\alpha)\,\mathrm{EMA}_{t-1}$,必須明確設定adjust=False——講者刻意強調這一點,正是初學者最容易出錯的參數。 - NaN 不是錯誤,是「未定義」:SMA 期初出現空值,本質是窗口未填滿、平均值在數學上不存在,而非程式出錯。
min_periods=1雖能填補期初,但那些值只由一兩個數據點構成,統計意義薄弱;做策略回測時,宜想清楚期初數據要保留還是捨棄。 - α 與窗口 M 只是近似對應:坊間常以 $\alpha \approx 2/(M+1)$ 把 EMA 與 SMA 的「快慢」掛鈎,但兩者權重結構根本不同——SMA 窗口外權重歸零,EMA 權重無限延伸。比較兩條均線的反應速度時,這只是粗略參考,不宜混為一談。
- 理論與實作宜對照着讀:本 lab 每個程式結果都對應第 11 講的一條公式,建議先重溫第 11 課的推導再看本篇,會更明白講者為何堅持逐項手動驗證。
- 數據接口有時效:本 lab 以 yfinance 取數、數據截至 2023 年初;yfinance 屬非官方接口,Yahoo Finance 改版時程式或需調整,重現實驗時宜留意套件版本。
名詞解釋
- 移動平均線 Moving Average:以滾動窗口對價格序列取平均得出的平滑曲線,用來濾除短期噪音、顯現趨勢。
- 簡單移動平均線 SMA:窗口內各期等權重的移動平均,窗口越長曲線越平滑。
- 指數移動平均線 EMA:近期價格權重較高、權重按指數衰減的移動平均,反應較 SMA 靈敏。
- 調整後收市價 Adjusted Close:經股息與拆股回溯調整的收市價序列,是量化計算的標準輸入。
- yfinance 股價數據套件:Python 開源套件,可免費從 Yahoo Finance 下載歷史價量數據。
- 回望窗口 Look-Back Window:策略用來觀察歷史數據的固定時間長度,對應 SMA 的窗口大小。
- 交叉 Crossover:兩條均線上下位置互換的時點,常用作趨勢轉向訊號。
常見問題 FAQ
為什麼 SMA 計算結果的開頭幾行是 NaN?
因為窗口尚未填滿。以窗口 $M$ 計算時,首 $M-1$ 期之前沒有足夠歷史數據,平均值在定義上不存在,pandas 以 NaN 標示。若設 min_periods=1,期初會以不足額的數據先行計算,但那些值的平滑意義有限。
ewm 的 adjust 參數應該怎樣設定?
要重現教科書的遞推公式 $\mathrm{EMA}_t = \alpha S_t + (1-\alpha)\,\mathrm{EMA}_{t-1}$,應設 adjust=False。預設的 adjust=True 會對整條序列做歸一化加權平均,期初數值會與遞推定義不同,兩者不可混用。
EMA 的 α 與 SMA 的窗口大小有沒有對應關係?
坊間常用 $\alpha \approx 2/(M+1)$ 作粗略換算,例如 $\alpha=0.1$ 約對應 19 期 SMA 的「快慢」。但兩者權重結構不同——SMA 窗口外權重為零,EMA 權重指數衰減且無限延伸,這個換算只宜當參考。
均線參數(窗口或 α)應該如何選擇?
沒有標準答案。窗口小或 $\alpha$ 大,曲線貼近價格、訊號多但雜訊也多;窗口大或 $\alpha$ 小,曲線平滑但滯後。參數對策略表現影響極大,須配合回測驗證,並警惕過度擬合歷史數據的風險。
原影片
本文整理自以下影片,版權屬原創作者所有,建議配合原片觀看: