Lab 4 實作:動量策略 Momentum Trading 的 Python 實戰|Quant Theory 第 21 講筆記
第 21 課・共 34 課
目錄
這是 Liu Peng 大學級量化交易課程第四個實作 lab 的筆記,主題是以 Python 完整實作動量策略 Momentum Trading。策略的理論基礎——橫截面動量、多空組合的構建邏輯——第 12 講已有講解(詳見動量策略|第 12 課);本 lab 在 Colab 環境把理論落地:由抓取道指 30 隻成分股開始,經過月回報換算、六個月滾動累積回報、五分位分組選股,到最後計算策略回報並與買入持有基準對照,走完整個量化策略的最小流程。
學習重點
- 數據源可以「免費拼湊」:成分股名單用 requests 加 BeautifulSoup 從 Wikipedia 表格爬取,價格數據用 yfinance 下載,零成本搭出研究數據集。
- 日回報轉月回報用
pct_change加resample:把日簡單回報加一後連乘再減一,才是正確的月累積回報,不能直接相加。 - 滾動窗口計形成期回報:
(1+R).rolling(6).apply(np.prod) - 1一行完成過去六個月累積回報,期首五個月因數據不足為 NaN。 qcut按分位數分組:30 隻股票按回報排名切成五組,最強一組做多、最弱一組做空,動量組合即成。- 策略回報 = 做多組平均 − 做空組平均:實驗期內動量組合錄得約 1.5% 回報,同期買入持有基準約 -4%。
詳細筆記
策略回顧與環境準備
講者開場先扼要重溫動量策略的定義:對一組資產,買入過去表現最強的一群(做多),同時沽空過去表現最弱的一群(做空)。背後假設是強者延續強勢、弱者延續弱勢——表現的「慣性」會在未來一段時間內持續。這正是第 12 講介紹的橫截面動量 Cross-Sectional Momentum:比較的是資產之間的相對強弱,而非單一資產自身的走勢。
實作環境是 Google Colab,講者先安裝並匯入所需套件:numpy 與 pandas 負責數值與表格運算,yfinance 負責下載股價,另有 requests 與 BeautifulSoup 負責網頁抓取。整個 lab 不使用任何付費數據源,全部數據來自公開網頁與 Yahoo Finance。
第一步:從 Wikipedia 爬取道指成分股名單
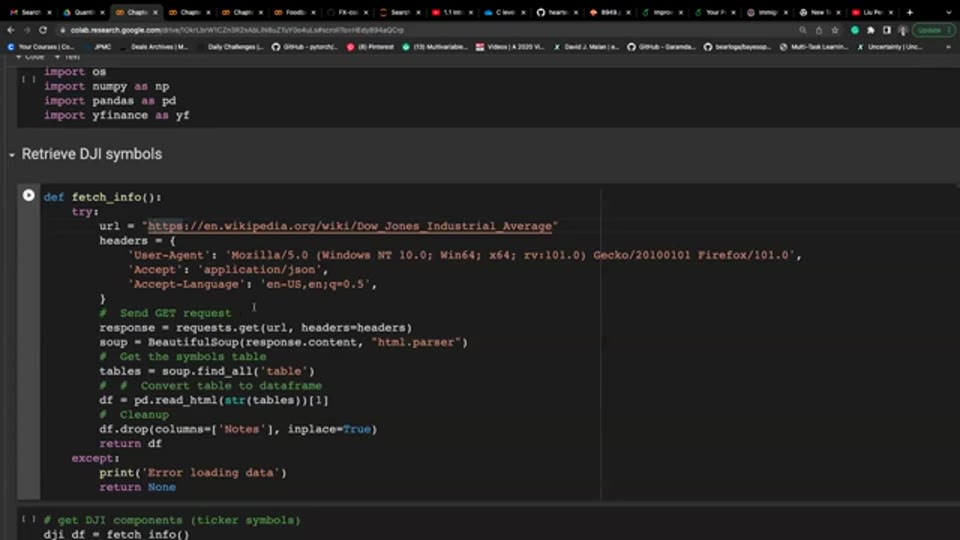
策略需要一個明確的資產池。講者選用道瓊斯工業平均指數的 30 隻成分股,但名單並非手動輸入,而是寫一個函數即場從 Wikipedia 的道指條目頁面爬取:
# 摘錄自原片教學
url = "https://en.wikipedia.org/wiki/Dow_Jones_Industrial_Average"
response = requests.get(url, headers=headers)
soup = BeautifulSoup(response.content, "html.parser")
tables = soup.find_all("table")
df = pd.read_html(str(tables))[1]
流程分三層:先用 requests 向該網址發出 HTTP 請求取回整頁內容(附帶 User-Agent 等標頭模擬瀏覽器);再用 BeautifulSoup 解析 HTML,以 find_all("table") 定位頁面中的表格元素——該頁內描述成分股的表格只有一個,容易鎖定;最後交給 pandas 的 read_html 把 HTML 表格直接讀成 DataFrame,略作清理(去掉 Notes 一欄)即成。講者提醒:30 隻成分股並非一成不變,指數公司會不時調整名單,所以「即場爬取」比「硬編碼名單」更符合實務——程式每次運行都取到當時的最新成分。
名單到手後,只取 Symbol 一欄轉成 Python list,便可直接餵給 yfinance。
第二步:下載價格並換算月回報
把 30 個股票代碼以 list 形式傳入 yfinance 的 download 函數,一次過下載全部股票的歷史數據,實驗取用的時段橫跨 2021 年初至 2022 年 9 月。回傳的 DataFrame 以日期為索引、每欄對應一隻股票;講者只保留調整後收市價 Adjusted Close,因為它已剔除拆股與股息造成的跳空,是回報計算的標準輸入。
接着是頻率轉換:策略以月為決策單位——月度是較能代表整體表現的聚合尺度——要把日線數據聚合為月回報。做法是先以 pct_change 把價格轉成日簡單回報,再用 resample('M') 按月分組,最後以 agg 指定聚合方式:
# 摘錄自原片教學
mth_return_df = df.pct_change().resample('M').agg(lambda x: (x+1).prod()-1)
這一行對應的數學是把月內每日的 $1+r$ 連乘再減一:
$$R^{(m)} = \prod_{d=1}^{D}(1+r_d) - 1$$其中 $r_d$ 是第 $d$ 個交易日的簡單回報,$D$ 是該月交易日數目。連乘體現複利效應——這是累積回報唯一正確的算法,把日回報直接相加會得出錯誤結果。輸出的月回報 DataFrame 以每月月末日期為索引,每格是該股該月的簡單回報。
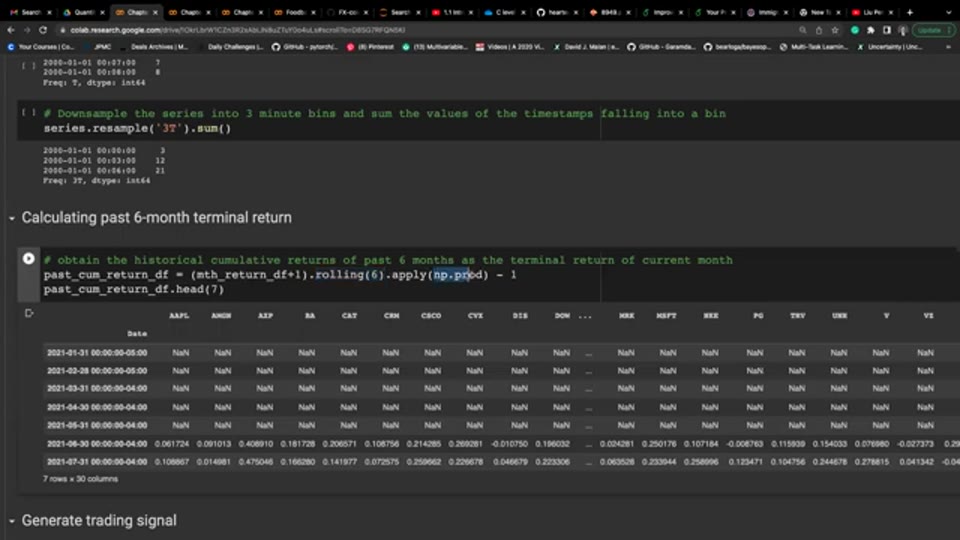
為免學生對 resample 一知半解,講者特別插入一個玩具例子:建立一條 0 至 8、以一分鐘為間隔的時間序列,再以 resample('3T').sum() 按三分鐘一組求和——首三個值 0、1、2 相加得 3,次三個值 3、4、5 相加得 12,一目了然。resample 的本質就是「按時間段分箱,再對每箱做聚合」,放在月回報場景,箱子是月份,聚合方式是連乘。
第三步:滾動六個月累積回報(形成期)
單看一個月回報太短,排名易受單月噪音主導。動量策略的標準做法是看形成期 Formation Period 的累積表現——本 lab 用六個月:站在某個月末,回望過去六個月(包括當月),計算累積回報作為強弱排名的依據。數學上同樣是 $1+R$ 連乘:
$$R^{(6)}_t = \prod_{k=0}^{5}\left(1+R^{(m)}_{t-k}\right) - 1$$程式上用 rolling 加 apply 一行完成:
# 摘錄自原片教學
past_cum_return_df = (mth_return_df + 1).rolling(6).apply(np.prod) - 1
rolling(6) 把窗口沿時間軸逐月滾動,每個窗口含六個月的 $1+R$ 值;`apply(np.prod)` 對窗口內六個數連乘,得出 \$1+R$ 形式的累積回報;最後減一轉回簡單回報。輸出的 DataFrame 首五行全是 NaN——前五個月沒有足夠歷史數據填滿六期窗口,累積回報在定義上不存在,與第 19 講 SMA 期初空值同理;由第六個月起,每格才是貨真價實的「過去六個月累積回報」。
第四步:劃分三個時期,鎖定選股空間
進入訊號生成前,講者先清楚劃分三個時期,這是理解整個流程的骨架:
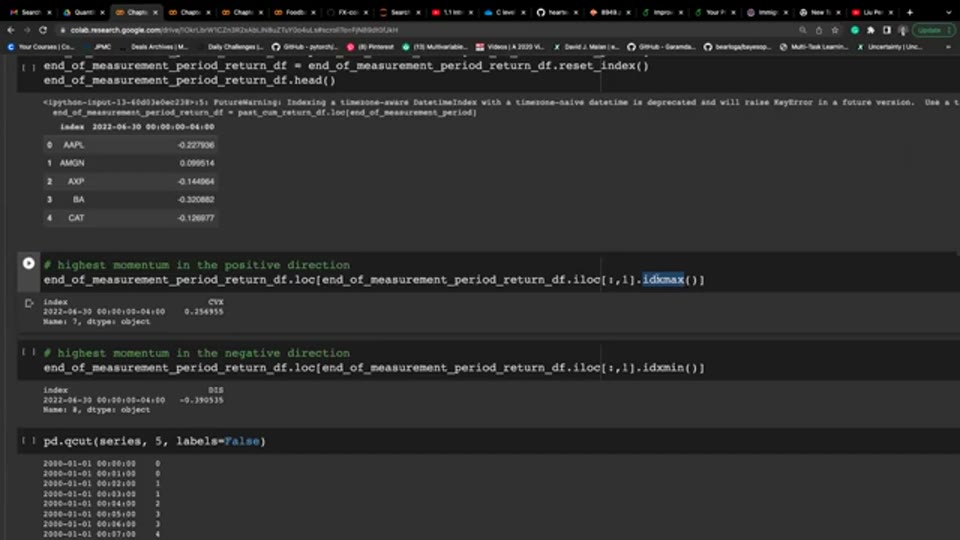
- 量度期末:歷史數據的截止點,本實驗為 2022 年 6 月末。該點的六個月累積回報,就是用來排名的成績表。
- 形成期(決策月):當下所處的月份,即 2022 年 7 月。站在這裡回望截至 6 月的歷史,作出建倉決定。
- 評估期:形成期之後一個月,即 2022 年 8 月。策略建倉後的實際表現在這裡檢驗。
三步對應「看歷史、下決定、驗成果」,時間上嚴格先後排列,不存在用未來數據做決定的問題。
選股空間是量度期末(2022 年 6 月末)那一行的數據:30 隻股票各自的六個月累積回報。講者先用 idxmax 找出回報最高的股票——理論上屬於最強的一群,將會做多;再用 idxmin 找出回報最低者——將會做空。這兩步只是熱身,真正的分組交給 qcut。
第五步:qcut 五分位分組,多空建倉
qcut 是 pandas 的分位數分組函數:把序列按數值大小排序後切成若干個元素數目相等的組。講者先以一條十元素的序列示範 pd.qcut(series, 5, labels=False):切五組、每組兩個元素,輸出的組別標籤由 0(最小)到 4(最大)。
套用到真實數據:對量度期末那 30 個六個月累積回報做 qcut,分成五組、每組六隻,新增一欄 rank 記錄每隻股票所屬組別。rank 4 是回報最高的五分之一——做多;rank 0 是回報最低的五分之一——做空:
# 摘錄自原片教學
long_stocks = df.loc[df["rank"] == 4, "index"].values
short_stocks = df.loc[df["rank"] == 0, "index"].values
以 loc 篩出對應組別的索引(即股票代碼),兩張名單各六隻,多空組合就此建成。整個建倉邏輯完全由歷史回報排名驅動,不涉及任何主觀判斷。
第六步:評估期績效與買入持有基準
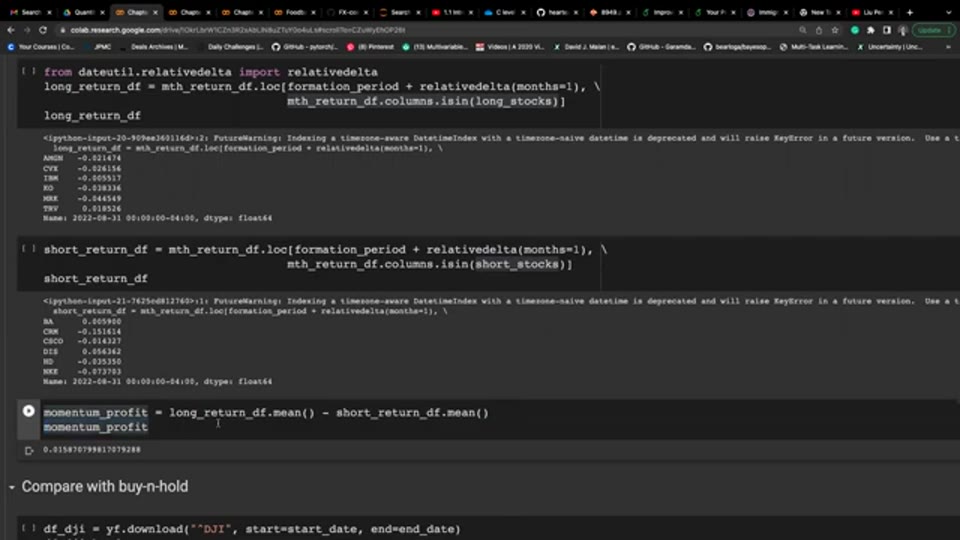
最後檢驗成果。用 dateutil 的 relativedelta(months=1) 把形成期推後一個月,定位評估期(2022 年 8 月)的月回報行,再以 columns.isin 分別抽出做多名單與做空名單的回報。兩組各取平均,做空組前面加負號(做空者從下跌中獲利),相加即得動量組合的月回報:
實驗結果約為 $+1.5\%$。講者再與買入持有 Buy and Hold 基準對照:下載道指本身(^DJI)同期數據,同樣經 pct_change 轉日回報、resample 聚合成月回報,取評估期的值——約為 $-4\%$。講者解釋背景:當時正值新冠疫情後遺與利率急升,大市普遍向下,買入持有全數承受跌幅;動量組合在同一月份錄得正回報,因為它做空了最弱的一組,從下跌的一端賺取了收益。至此,由取數、清洗、訊號、建倉到績效評估的完整流程走完,理論與程式一一對應。
🙏 覺得內容有用?本站所有內容免費提供,使用推薦碼開戶就是支持我們繼續營運的最大鼓勵:
ZA Bank 邀請碼 P20923
—— 你享 HKD 2,000 迎新獎賞,本站獲得營運支持。
立即開戶 →
(聯盟連結|投資涉及風險,受條款及細則約束,此資料僅可於香港境內分發)
欣利克的看法
- 一個月的勝出不構成證據:本實驗只展示單一評估期(2022 年 8 月),動量組合 +1.5% 對買入持有 -4% 的對比固然好看,但單期結果隨機成分極高。動量效應是否成立,要靠橫跨多年、數百個評估期的統計檢驗——這是學術文獻的做法,也是教學演示與策略驗證的分水嶺。
- 「先減一、連乘、再加回」是累積回報的唯一正解:日回報轉月回報、月回報轉六個月累積回報,兩處都用 $(1+R)$ 連乘再減一。初學者常犯的錯是把簡單回報直接相加,數值小時誤差不大,數值大或期數多時偏差明顯,實作時必須養成連乘的習慣。
- 做空端的會計要分清方向:策略回報寫成 $\bar{R}_{\text{long}} - \bar{R}_{\text{short}}$,負號體現做空者從下跌獲利。常見誤區是忘記加負號,或把「做空組的平均回報」誤當策略的虧損來源——實際上做空組跌得越多,策略賺得越多。
- 與第 12 講對照讀最有益:本 lab 是第 12 講理論的逐行程式化——形成期、五分位分組、多空對沖的概念如不熟悉,建議先重溫第 12 課再動手重現,會更明白每行程式碼對應哪一個理論部件。
- 數據接口與名單有時效:Wikipedia 頁面結構一改版,爬蟲便可能失效;道指成分股亦會不時換馬,重現實驗所得的名單與原片未必一致。截至 2026 年中,yfinance 仍屬非官方接口,使用時宜留意套件版本與數據完整性。
名詞解釋
- 動量 Momentum:資產價格延續近期走勢的傾向,強者愈強、弱者愈弱的經驗規律。
- 橫截面動量 Cross-Sectional Momentum:在同一時點比較多隻資產的相對表現,買入強者、沽空弱者的策略。
- 形成期 Formation Period:用來量度資產過去表現、據此排名分組的歷史觀察窗口。
- 沽空 Short Selling:先借貨賣出、日後買回歸還的操作,從價格下跌中獲利。
- 買入持有 Buy and Hold:建倉後長期持有的被動策略,常用作衡量主動策略的基準。
- 簡單回報 Simple Return:期末價減期初價再除以期初價的回報度量,跨期累積須經 $1+R$ 連乘。
- 調整後收市價 Adjusted Close:經股息與拆股回溯調整的收市價,是回報計算的標準輸入。
- yfinance 股價數據套件:Python 開源套件,可免費從 Yahoo Finance 下載歷史價量數據。
- 回測 Backtesting:以歷史數據模擬策略表現的驗證方法,須避免使用未來數據。
常見問題 FAQ
為什麼月回報不能直接把每日回報相加?
因為回報有複利效應。今日的回報是在昨日已變動的本金上計算的,正確做法是把每日的 $1+r$ 連乘再減一,即 $R = \prod(1+r_d)-1$。直接相加在數值小時看似接近,但期數一多或波動一大,偏差便會浮現。
qcut 與手動排名有什麼分別?
qcut 按分位數分組,保證每組元素數目大致相等——30 隻股票切五組,每組剛好六隻,多空兩端規模對稱。手動排名再取頭尾若干隻也能達到類似效果,但 qcut 一行完成排序、分箱、貼標籤三個步驟,程式更簡潔,也不易出錯。
為什麼累積回報 DataFrame 的開頭幾個月是 NaN?
因為滾動窗口尚未填滿。以六個月窗口計算時,首五個月之前沒有足夠歷史數據,累積回報在定義上不存在,pandas 以 NaN 標示;由第六個月起窗口首次填滿,才有有效數值。這與移動平均線期初出現空值是同一道理。
實驗中動量策略跑贏買入持有,是否證明策略有效?
不能這樣推論。實驗只涵蓋 2022 年 8 月一個評估期,且當時大市因加息普遍下跌,做空端自然佔優,單期結果隨機成分極高。嚴謹驗證需要在多年數據上重複整個流程數百次,檢驗平均回報的統計顯著性,並計入交易成本後再下結論。
原影片
本文整理自以下影片,版權屬原創作者所有,建議配合原片觀看: