策略優化入門:目標函數、格點搜尋與過度擬合風險
第 24 課・共 34 課
目錄
策略優化 Strategy Optimization 是量化交易由「識做策略」走向「識調策略」的分水嶺:參數組合千變萬化,人手逐一試根本試不完。本講是 Liu Peng 量化交易學術課第 11 週第一講,正式進入參數優化課題——講者把交易策略重新表述為一個全局優化 Global Optimization 問題:參數是輸入、夏普比率是輸出,目標是在龐大的搜尋空間裡有系統地找出全局最大值。
學習重點
- 人手調參的兩道死結:可選參數值太多(連續取值近乎無限),加上每次回測都要時間,逐個試在計算上不可行。
- 參數化策略:把策略參數(如雙均線的兩個窗口長度)看成輸入變量,回測績效(如夏普比率)看成輸出,策略就成為一個函數 $S = f(l_1, l_2)$。
- 黑箱函數:這個函數沒有明確數學形式、沒有梯度資訊,機器學習慣用的梯度下降派不上用場,要用全局優化工具。
- 全局優化的數學表述:目標是找出 $f^* = \max_{x \in \mathcal{X}} f(x)$ 及其位置 $x^* = \arg\max$,搜尋必須有原則地分配有限的計算資源。
- 優化的陰暗面:參數調得越盡,越可能只是在遷就歷史噪音——多時段、多場景回測是檢驗穩健性的基本門檻。
詳細筆記
為何人手調參行不通
講者開篇先講穩健性:不同測試時段的資產價格曲線各有特性,一套參數要稱得上穩健,就要在多個覆蓋代表性場景的時段回測——包括市場崩盤這類小概率事件——仍然保持盈利,才有機會在實盤繼續有效。講者特別界定:實盤測試 Live Test 是指把策略真正放到市場運行一段時間,觀察它在未見過的數據上能否複製回測表現;回測過關只是入場券,實盤才是終極驗證。
但這個要求馬上令「手動微調」變得不切實際,原因有二。第一是參數空間太大:之前課堂的進出場訊號用 Z-score 門檻,例如設為 2;但 2 可以是 1.9、1.91、1.9001……連續取值近乎無限,我們無從得知哪個才是最優。第二是單次評估太慢:每組參數要跑多個時段的回測才有結論,每一輪執行都耗時,想知單一參數組合的表現也要等上一段時間。兩者疊加,令「全局搜尋最優參數」成為一個必須借助優化算法才能處理的問題,而非靠人手可以完成的工序。
參數化交易策略與目標函數
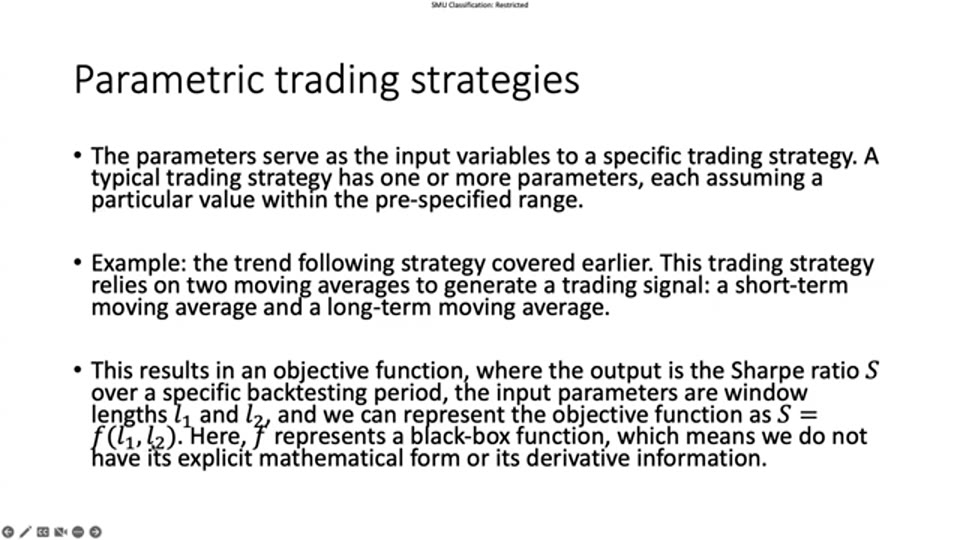
講者把討論對象界定為參數化交易策略 Parametric Trading Strategy:策略建基於一個或多個參數,這些參數就是輸入變量,也是我們可以擰動的「調節旋鈕」,每個參數都在預設範圍內取值。例子包括:
- 均值回歸策略的 Z-score 進出場門檻,可由 0 一路調到 3、4 甚至 5;
- 趨勢跟蹤策略依靠短期與長期兩條移動平均線,兩個窗口長度 $l_1$、$l_2$ 就是參數。
有了輸入,就要定義輸出。目標函數 Objective Function 接收參數值、輸出一個績效指標。講者選用夏普比率 Sharpe Ratio 作為績效度量,在某段回測期上計算。留意這裡的取捨:績效指標只輸出單一標量,把回測裡千絲萬縷的資訊壓縮成一個數字,優化器只認這個數字——選錯指標,優化方向整個歪掉。數學上,對於兩個窗口長度的策略:
$$S = f(l_1, l_2)$$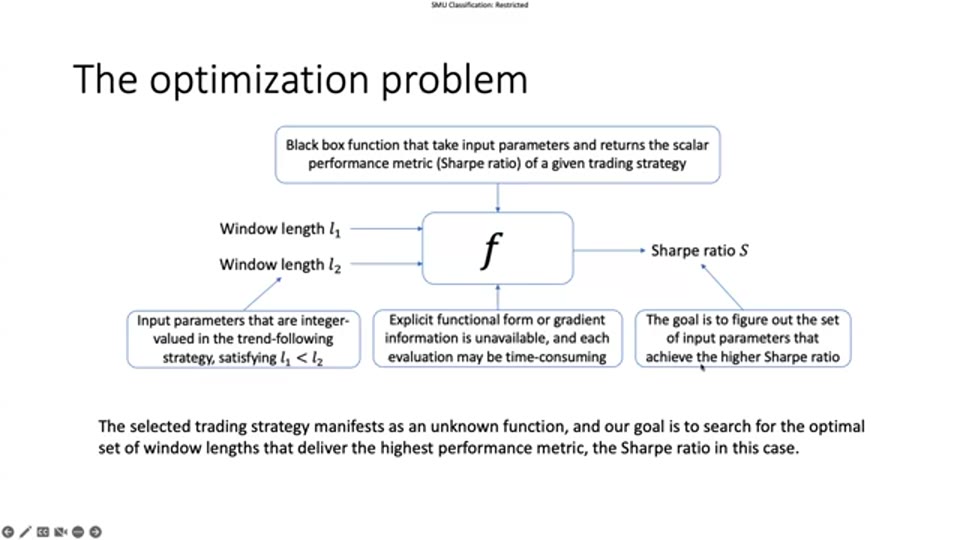
黑箱函數:無封閉形式、無梯度
講者特別強調 $f$ 是一個黑箱函數 Black-box Function:我們知道怎樣計算它——給定參數,跑一次回測就有夏普比率——但它沒有固定的數學形式,無法做符號推導、求不出封閉解。
這一點與機器學習慣常面對的問題有本質分別。講者解釋,若函數有明確形式,數學分析會容易得多——可以求導、找臨界點、甚至推出封閉解。訓練深度神經網絡時,損失函數的梯度可以計算,於是梯度下降大行其道;但策略績效函數的梯度資訊不存在,梯度下降直接出局。加上每次函數評估(一回測)都耗時,我們連「在附近多試幾點、用差分逼近梯度」的做法都難以負擔。這正是全局優化工具存在的意義:在無梯度、評估昂貴的條件下,仍有系統地搜尋最優解。
全局優化問題的數學表述
講者把問題正式寫成約束優化。以雙均線策略為例,決策變量是兩個窗口長度 $l_1$、$l_2$,要滿足:
- 兩者皆為整數(窗口長度沒有小數可言);
- 短窗口必須小於長窗口,即 $l_1 < l_2$;
- 函數無明確形式、無梯度資訊。
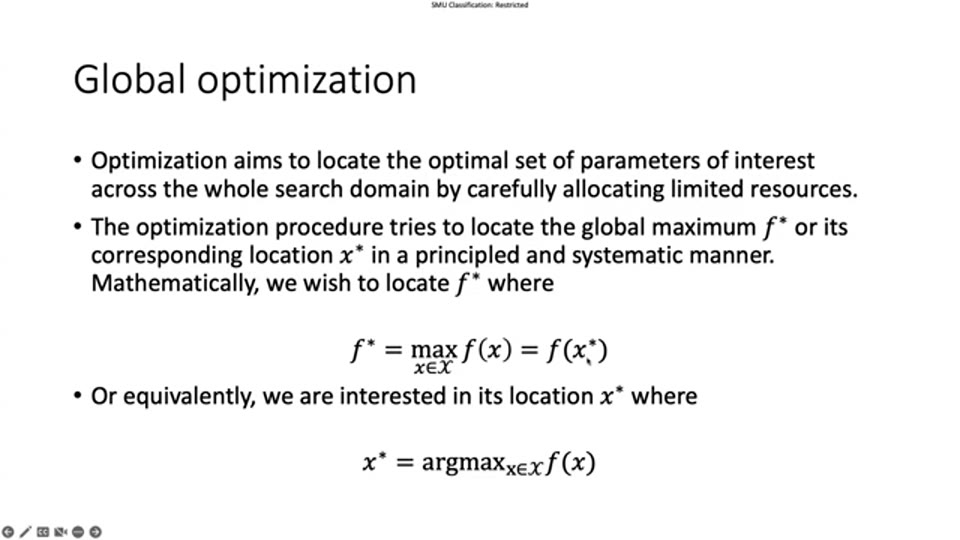
目標是找到令夏普比率最大的參數組合。講者給出兩個等價表述。其一是全局最大值:
$$f^* = \max_{x \in \mathcal{X}} f(x) = f(x^*)$$其中 $\mathcal{X}$ 是整個搜尋空間(函數的定義域),$f^*$ 是所有可能參數評估出來的最高夏普比率。其二是最優位置,用 argmax 表示「令函數取最大值的那個輸入」:
$$x^* = \arg\max_{x \in \mathcal{X}} f(x)$$找到 $x^*$ 後再評估一次,得到的函數值就是 $f^*$,兩者互為表里:一個問「最高可以去到幾高」,另一個問「最高峰在哪裡」。
這個問題屬於全局優化的範疇,與只求局部改進的方法不同:我們關心的是整個搜尋域上的最優參數集,而非起點附近的小幅改善。
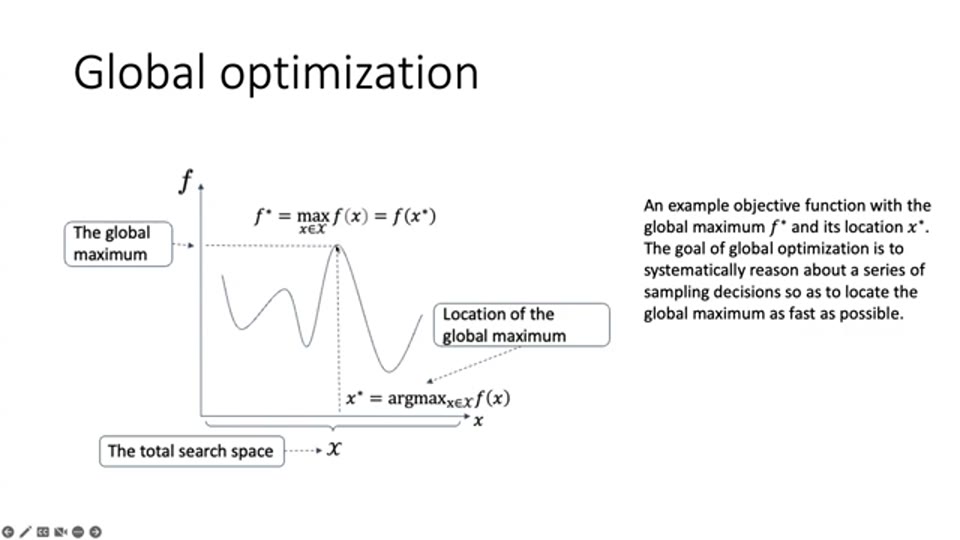
講者用一條多峰曲線說明難度所在:橫軸是參數 $x$、縱軸是目標函數值,曲線上有好幾個局部高峰,全局最大值只有一個。由任意起點出發,如何「落點」在全局最高峰而非旁邊的小山頭,就是全局優化的核心挑戰——貪心爬坡只會被困在就近的局部最優。而且計算資源有限——不能漫無目的地亂試,搜尋必須有原則、有系統,把有限的評估次數花在最有希望的位置。
格點搜尋:最直觀但最昂貴的基準
面對這個問題,最直觀的做法是格點搜尋 Grid Search:為每個參數設定取值範圍與步距,鋪成一張多維網格,逐點回測,揀最高分之一點。若有 $d$ 個參數、第 $i$ 個參數取 $n_i$ 個值,總評估次數是:
$$N = n_1 \times n_2 \times \cdots \times n_d$$組合數目隨維度指數爆炸:兩個參數各取 50 個值已是 2,500 次回測;三個參數就變 125,000 次。以每次回測動輒以分鐘計,格點搜尋只能當基準方法,實務上難以獨力承擔全局搜尋。以 Z-score 門檻為例,若在 0 至 4 之間以 0.1 為步距,單一參數已有 41 個取值;兩個門檻(進場、出場)加兩個均線窗口,四維網格的規模隨即失控。步距放寬可以省時間,卻又可能錯過落在格點之間的真正最優——進退兩難。這正是後續課題引入更聰明優化算法的動機。
過度擬合:調參的隱藏代價
講者在本講埋下的另一條伏線,與優化相輔相成:參數調得越盡,越要警惕過度擬合 Overfitting。一套參數在單一時段跑出最高夏普比率,可能只是遷就了該段行情的噪音;所以講者開篇才強調要用多個覆蓋不同場景(包括崩盤等小概率事件)的時段驗證。能在多段歷史都生存的參數,才算穩健 Robust,才有條件進入實盤測試。換句話說,優化與驗證是兩道工序:優化算法負責「找得快」,多時段驗證負責「找得真」,兩者缺一不可。
🙏 覺得內容有用?本站所有內容免費提供,使用推薦碼開戶就是支持我們繼續營運的最大鼓勵:
ZA Bank 邀請碼 P20923
—— 你享 HKD 2,000 迎新獎賞,本站獲得營運支持。
立即開戶 →
(聯盟連結|投資涉及風險,受條款及細則約束,此資料僅可於香港境內分發)
欣利克的看法
- 「最優參數」只是一個時點的答案。 本講的數學框架乾淨俐落,但要記住 $f^*$ 是「這段歷史數據上的最大值」,不是「未來的最大值」。市場結構一改變,舊的 $x^*$ 可能一文不值,所以講者才把多場景回測放在整個框架之前。
- 目標函數的選擇本身就是主觀判斷。 用夏普比率做目標,等於宣告「我在乎風險調整後的回報」;若改用淨盈利,優化器會樂意選出回撤驚人的參數組合。常見誤區是以為優化是純技術問題,其實「優化甚麼」比「怎樣優化」更早決定結果。
- 格點搜尋的「保證找到」是假象。 它保證找到的是格點上的最佳,而不是連續空間的真正最優;格點加密十倍、計算量也漲十倍,但過度擬合風險同時上升——試得越多組合,越容易撞中純靠運氣跑贏的一組,詳見過度擬合詞條。
- 浮誇回測數字往往是調參的產物。 Saleh 系列第 13 課的 4983% 案例,正是單一標的、單一時段反覆調整後的樣本內數字,講者自己也花大量篇幅解畫(見三重 TEMA 策略拆解的防坑討論)。看任何「優化後」的績效,先問樣本外表現,是本講框架最實用的延伸。
- 本講數學截至 2023 年的課程內容,屬經典框架。 無梯度優化近年有新工具(如貝葉斯優化普及化),但「黑箱、評估昂貴、全局搜尋」這個問題設定歷久常新,值得先打好基礎再追新法。
名詞解釋
- 目標函數 Objective Function:優化問題中要最大化或最小化的函數;量化交易裡輸入是策略參數、輸出是績效指標。
- 格點搜尋 Grid Search:在參數網格上逐點枚舉、全部回測再揀最佳的調參方法,直觀但計算量隨維度爆炸。
- 夏普比率 Sharpe Ratio:超額回報除以波動率的風險調整績效指標,本講用它做目標函數的輸出。
- 移動平均線 Moving Average:把一段窗口內的價格取平均的趨勢指標;雙均線策略的兩個窗口長度正是本講的示範參數。
- 回測 Backtesting:用歷史數據模擬策略表現的驗證方法;每次目標函數評估本質上就是一次回測。
- 過度擬合 Overfitting:參數過度遷就歷史噪音,回測亮麗但換個時段即走樣,是調參最大的陷阱。
- 樣本外測試 Out-of-sample Testing:用從未參與調參的數據驗證策略,檢驗優化結果是否真實有效的關鍵步驟。
常見問題 FAQ
策略優化和過度擬合有甚麼關係?
優化是在歷史數據上找績效最好的參數,但試的組合越多、調得越盡,越可能只是在遷就該段數據的噪音而非真實規律——這就是過度擬合。防範方法是把數據分為樣本內與樣本外,並用多個覆蓋不同市況的時段驗證。
為甚麼不能用機器學習的梯度下降來調策略參數?
梯度下降需要目標函數的梯度資訊,而策略績效函數是黑箱:給定參數只能跑一次回測得到數值,沒有明確數學形式可求導,梯度根本不存在,所以要用全局優化一類不依賴梯度的方法。
格點搜尋一定找得到最佳參數嗎?
只能保證找到「格點上」的最佳。若真正最優值落在格點之間就會錯過;而格點加密會令評估次數以乘法倍增,計算成本極高,因此它通常只作為基準方法。
目標函數一定要選夏普比率嗎?
不一定,夏普比率只是常見選擇,也可用卡瑪比率、淨盈利等。但要留意目標函數定義了「好策略」的標準:只最大化淨盈利容易選出高風險參數,用風險調整後的指標通常較穩健。
原影片
本文整理自以下影片,版權屬原創作者所有,建議配合原片觀看: