高斯過程 Gaussian Process 與採集函數:貝葉斯優化的數學引擎
第 26 課・共 34 課
目錄
為策略參數(例如均線窗口長度)找最佳值,每次試錯都要跑一次回測,成本極高。貝葉斯優化 Bayesian Optimization 用更少次試驗找到好參數,而本講(Liu Peng 課程第 11 講第 3 段)正是拆解它的數學引擎:高斯過程 Gaussian Process 負責逼近未知的目標函數並量化不確定性,採集函數 Acquisition Function 負責決定下一個試點。本篇筆記按原片脈絡重構,公式以 LaTeX 重寫。
學習重點
- 高斯過程把有限維高斯分佈推廣到連續函數空間:任意有限點集聯合服從多元正態分佈
- 觀測數據後,後驗均值穿過觀測點、該處方差歸零;均值與方差有閉式解
- 採集函數是人工設計、計算便宜的評分函數,其最大值點就是下一個採樣位置
- 預期改善(EI)有閉式解,兩項分別對應利用與探索;上置信界(UCB)用系數 $\beta$ 顯式調節兩者比重
- 完整貝葉斯優化循環:代理模型提議試點 → 環境回傳觀測 → 更新後驗,直至用盡試錯預算
詳細筆記
高斯過程:由分佈到函數空間
講者開宗明義:高斯過程是貝葉斯優化中的代理模型 Surrogate Model,用來逼近真正的目標函數——在策略調參情境下,就是「參數值 → 夏普比率」這條看不見的黑盒函數。它是一種隨機過程(stochastic process),核心性質只有一條:定義域內任意選取有限個點,其函數值聯合起來都服從多元高斯分佈。單一點是高斯分佈,任意點集合起來也是高斯分佈。
可以這樣理解推廣方向:過去我們處理的是有限維的高斯分佈,輸入是離散的有限個變數;高斯過程把輸入域變成連續——整個參數範圍內有無限多個點,每點各是一個隨機變數,但它們的聯合行為仍由高斯結構規範。正因為高斯分佈足夠靈活,這個框架能建模相當廣泛的一族函數,成為強大的代理模型。
先驗:未有數據時的信念
未收集任何數據時,高斯過程代表我們對目標函數的先驗信念 Prior Belief。講者展示的示意圖中,實線是先驗均值函數(水平直線),兩條虛線是 95% 置信區間 Credible Interval——意思是真實函數約 95% 時間落在這範圍內。在橫軸任選一點(例如某個窗口長度),都能抽出對應的先驗預測分佈:一個有均值、有方差的隨機變數。
從先驗過程抽樣,抽到的不是數字而是整條曲線——因為模型建模的對象是函數。講者示範抽三條樣本函數,大部分時間它們都躺在 95% 區間內,偶爾越界,這正反映先驗的不確定性。
後驗更新:觀測如何改變模型
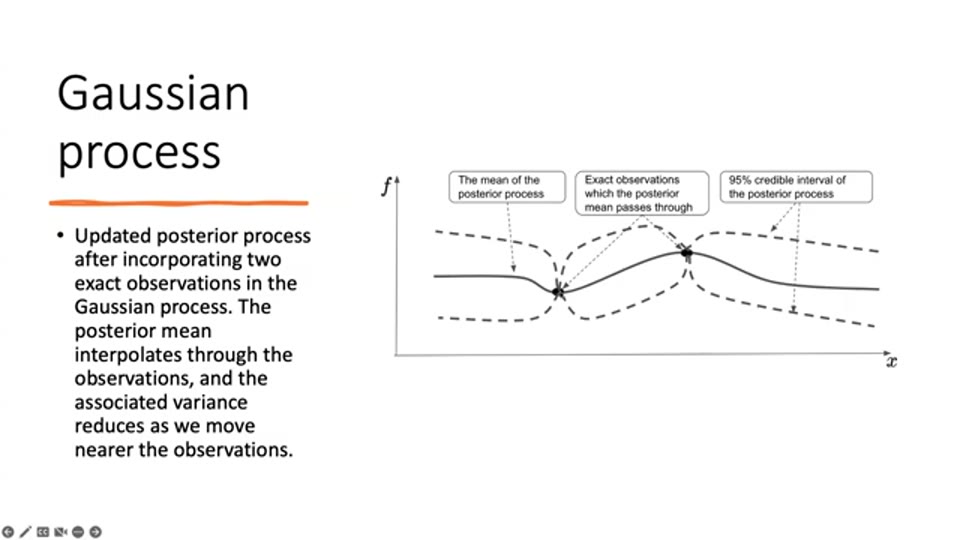
開始收集數據後,模型便「學習」。所謂一個觀測,在策略調參中就是:試了一組參數、跑回測、得到一個夏普比率。講者以兩個觀測點為例,更新後的後驗過程 Posterior Process 有兩個關鍵特徵:
- 後驗均值曲線穿過觀測點——已觀測的就是事實,模型必須插值經過
- 觀測點處方差歸零——已知答案的位置沒有不確定性;離觀測點越遠,不確定性越大
後驗均值與方差的閉式解
數學上,設已有 $n$ 個觀測組成的數據集 $\mathcal{D}_n = \{(\mathbf{x}_i, f_i)\}_{i=1}^{n}$,其中 $\mathbf{x}_i$ 是採樣位置(參數)、$f_i$ 是對應的標量觀測(績效)。對任意新位置 $\mathbf{x}_* \in \mathcal{X}$,其函數值 $f_*$ 服從條件正態分佈:
$$p(f_*; \mathbf{x}_*, \mathcal{D}_n) = \mathcal{N}(f_* \mid \mu_*, \sigma_*^2)$$講者指出,後驗均值與方差可由多元高斯定理 Multivariate Gaussian Theorem 推出閉式解:
$$\mu_* = \mathbf{k}(\mathbf{x}_{1:n}, \mathbf{x}_*)\, \mathbf{K}(\mathbf{x}_{1:n}, \mathbf{x}_{1:n})^{-1}\, \mathbf{f}_{1:n}$$$$\sigma_*^2 = k(\mathbf{x}_*, \mathbf{x}_*) - \mathbf{k}(\mathbf{x}_{1:n}, \mathbf{x}_*)\, \mathbf{K}(\mathbf{x}_{1:n}, \mathbf{x}_{1:n})^{-1}\, \mathbf{k}(\mathbf{x}_{1:n}, \mathbf{x}_*)$$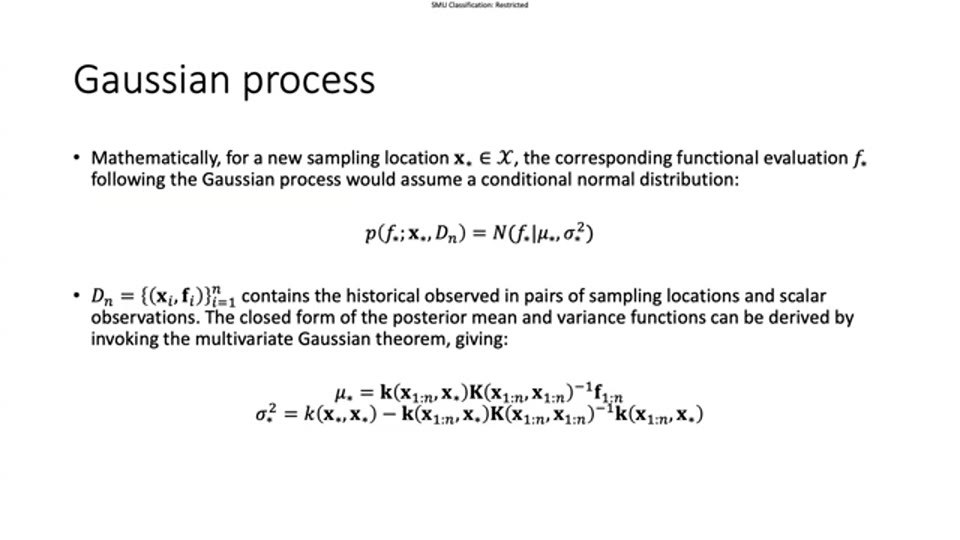
逐一拆解符號:$\mathbf{K}(\mathbf{x}_{1:n}, \mathbf{x}_{1:n})$ 是 $n \times n$ 的核矩陣,第 $(i,j)$ 個元素是核函數值 $k(\mathbf{x}_i, \mathbf{x}_j)$;$\mathbf{k}(\mathbf{x}_{1:n}, \mathbf{x}_*)$ 是新點與各觀測點核值組成的向量;$\mathbf{f}_{1:n}$ 是觀測值向量。核函數 Kernel Function(協方差函數)量度兩點函數值的相關程度,常見選擇如 RBF 核 $k(x, x') = \sigma^2 \exp\!\left(-\frac{\|x - x'\|^2}{2\ell^2}\right)$,即距離越近相關越高。
公式直觀:均值是觀測值的線性組合,權重由新點與觀測點的相關性決定;方差是自身先驗方差減去「觀測能解釋的部分」,因此必不為負,且在觀測點處收斂至零。有了閉式解,搜索空間內每一點都能即時算出一個高斯分佈——這正是後續決策的基礎。
採集函數:引導搜索的評分機制
有了代理模型,下一步是決策。採集函數 Acquisition Function 是人工設計的機制,為搜索範圍內每個候選參數算出一個純量分數,評估其相對潛力;分數最高的位置就是下一個採樣點,即下一組要實際回測的參數。
設計上有個硬要求:採集函數必須計算便宜。目標函數(回測)已經很貴,如果連「挑下一點」本身都貴,整個方法便失去意義。於是最大化採集函數成為我們自建的另一個(內層)優化問題,但因為函數便宜,這層優化可以做得相對徹底。
講者展示的採集函數曲線有一特徵:已觀測的歷史點處函數值為零——重複採樣已知位置沒有任何新增資訊,自然不應再試。
預期改善 EI:定義與推導
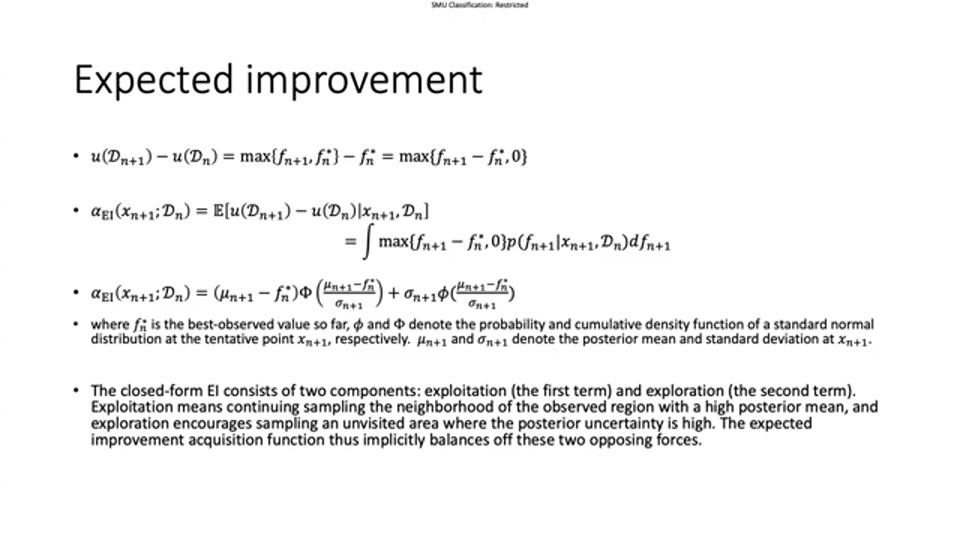
預期改善 Expected Improvement 是最流行的採集函數之一。基準是目前的最佳觀測值 $f_n^*$;新增一個觀測 $f_{n+1}$ 帶來的邊際效用為:
$$u(\mathcal{D}_{n+1}) - u(\mathcal{D}_n) = \max\{f_{n+1}, f_n^*\} - f_n^* = \max\{f_{n+1} - f_n^*,\, 0\}$$即新觀測比舊最佳好多少;若更差,改善為零(不會為負)。以策略語言說:新的夏普比率必須高於手上最佳紀錄才算有價值,否則計零。採集函數就是對這個邊際效用取期望,並對後驗分佈展開成積分:
$$\alpha_{\text{EI}}(\mathbf{x}_{n+1}; \mathcal{D}_n) = \mathbb{E}\left[u(\mathcal{D}_{n+1}) - u(\mathcal{D}_n) \mid \mathbf{x}_{n+1}, \mathcal{D}_n\right] = \int \max\{f_{n+1} - f_n^*,\, 0\}\; p(f_{n+1} \mid \mathbf{x}_{n+1}, \mathcal{D}_n)\, df_{n+1}$$EI 的最大好處是有閉式解,把後驗均值 $\mu_{n+1}$ 與標準差 $\sigma_{n+1}$ 直接代入即可:
$$\alpha_{\text{EI}}(\mathbf{x}_{n+1}; \mathcal{D}_n) = (\mu_{n+1} - f_n^*)\, \Phi\!\left(\frac{\mu_{n+1} - f_n^*}{\sigma_{n+1}}\right) + \sigma_{n+1}\, \phi\!\left(\frac{\mu_{n+1} - f_n^*}{\sigma_{n+1}}\right)$$其中 $\phi$ 與 $\Phi$ 分別是標準正態分佈的概率密度函數與累積分佈函數。
講者特別點出兩項的含義,這是全式靈魂:
- 第一項是利用 Exploitation:$\mu_{n+1}$ 越大、越拋離 $f_n^*$,此項越大——鼓勵在已知高均值區域的鄰近繼續挖掘
- 第二項是探索 Exploration:$\sigma_{n+1}$ 越大,此項越大——鼓勵試不確定性高、未踏足的區域
EI 因而隱式地平衡利用與探索。講者補充,這種 exploration–exploitation 權衡在強化學習中同樣核心,概念相通。
上置信界 UCB:顯式調節的權衡
另一個常用採集函數是上置信界 Upper Confidence Bound:
$$\alpha_{\text{UCB}}(\mathbf{x}_{n+1}; \mathcal{D}_n) = \mu_{n+1} + \beta_{n+1}\, \sigma_{n+1}$$結構極簡:均值加標準差的加權。$\beta_{n+1}$ 是使用者自設的逐階段超參數,顯式控制利用與探索的比重——$\beta$ 小,偏向利用(信賴均值);$\beta$ 大,偏向探索(重視不確定性)。與 EI 的自動平衡相比,UCB 把方向盤交給使用者,代價是要自己調 $\beta$。
完整貝葉斯優化循環
把兩個部件合起來,就是完整的迭代流程:
- 高斯過程以現有數據擬合後驗,給出每點的 $\mu$ 與 $\sigma$
- 採集函數據此評分,最大值點成為推薦的採樣位置(政策 policy 的輸出)
- 環境收到試點請求,按觀測模型回傳新觀測——即實際跑回測得出新夏普比率(觀測可含噪音)
- 新觀測加入數據集,高斯過程更新為新的後驗過程
- 重複直至用盡預算(例如預設的試驗次數上限)
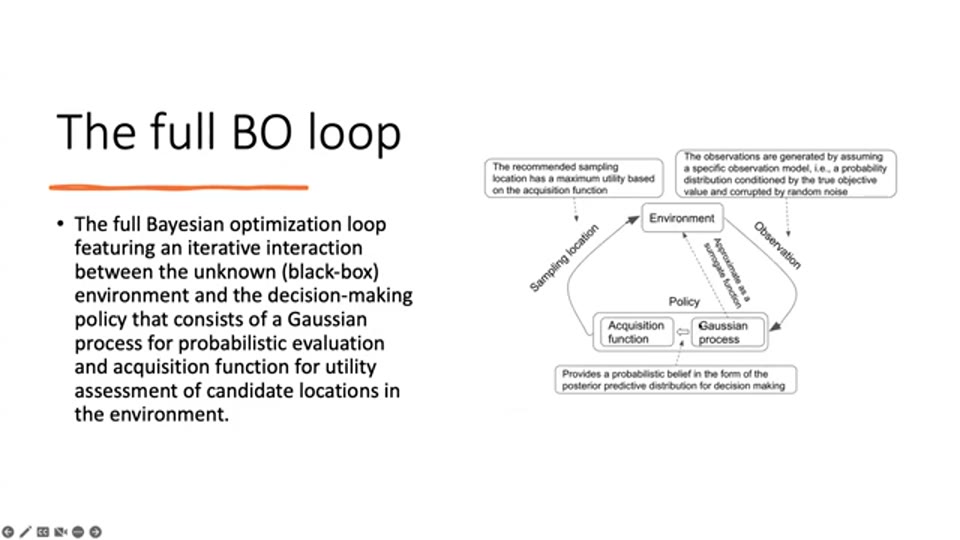
講者以框架圖總結:環境負責產生觀測,政策由高斯過程與採集函數組成,負責評估與推薦。強化學習由這裏開始分叉——它有自己的政策與推進世界的機制——但「環境—政策」的整體設定相同。整個搜索因此是有原則(principled)且迭代式地進行。
🙏 覺得內容有用?本站所有內容免費提供,使用推薦碼開戶就是支持我們繼續營運的最大鼓勵:
ZA Bank 邀請碼 P20923
—— 你享 HKD 2,000 迎新獎賞,本站獲得營運支持。
立即開戶 →
(聯盟連結|投資涉及風險,受條款及細則約束,此資料僅可於香港境內分發)
欣利克的看法
概念釐清:高斯過程輸出的是分佈,不是預測值。很多人把後驗均值當成「模型預測的夏普比率」,這只對了一半。GP 的真正價值在 $\sigma$——不確定性量化。沒有方差項,EI 的第二項消失、UCB 退化成純均值搜索,整個探索機制便不復存在。讀這套框架時,均值與方差要同等看待。
常見誤區:把貝葉斯優化當成市場預測工具。GP 逼近的是「參數 → 回測績效」這條函數,不是價格走勢。若回測本身帶過度擬合或前視偏差,BO 只會更高效地找到偏差最大的參數。它是搜索效率工具,不是績效保證,樣本外驗證依然不可省。
計算成本要知道:標準 GP 推斷涉及 $n \times n$ 核矩陣求逆,複雜度約 $O(n^3)$,觀測數過千便會明顯變慢,這也是 BO 適合「少量昂貴試驗」而非大數據場景的原因。文獻中有稀疏 GP 等近似方案,實作前宜了解所用庫的規模上限。
核函數選擇帶主觀性:原片聚焦推導,未有深入核函數的取捨。RBF 核隱含目標函數無限光滑的假設,Matérn 核則允許較粗糙的函數——「參數→績效」曲面是否光滑,無人能先知。不同核選擇會得出不同後驗與試點路徑,這層主觀性使用時要有自覺。
時效提醒:本片為 2023 年上載的大學課堂內容,講的是經典 BO 框架。截至 2026 年中,EI、UCB 仍是主流教科書內容,但學界已發展出多保真度、批量採樣等變體;Python 實作庫(如 BoTorch、GPyOpt)的 API 亦可能與原片實驗課有出入。
名詞解釋
- 高斯過程 Gaussian Process:任意有限點集聯合服從多元正態的隨機過程,BO 的代理模型
- 核函數 Kernel Function:量度兩輸入點函數值相關程度的協方差函數
- 貝葉斯優化 Bayesian Optimization:代理模型加採集函數的昂貴黑盒函數優化框架
- 採集函數 Acquisition Function:為候選點評分、決定下一採樣位置的人工設計函數
- 預期改善 Expected Improvement:以當前最佳觀測為基準的期望邊際增益,有閉式解
- 夏普比率 Sharpe Ratio:每單位風險的超額回報,本課的目標函數輸出
- 方差 Variance:量度隨機變數離散程度,GP 不確定性的載體
- 回測 Backtesting:用歷史數據評估策略,BO 中的「昂貴觀測」
- 過度擬合 Overfitting:模型過度遷就樣本內數據而失效於樣本外的現象
常見問題 FAQ
高斯過程與普通線性回歸有何分別?
線性回歸輸出的是一條擬合線與參數估計,本質上是點估計思維;高斯過程輸出的是整個函數空間上的機率分佈——每個未觀測點都有均值與方差。後者的方差項讓優化算法知道「哪裏不確定」,從而主動去探索,這是 BO 能比網格搜索少用試驗次數的關鍵。
EI 公式中 $\phi$ 與 $\Phi$ 是甚麼?
$\phi$ 是標準正態分佈的概率密度函數(鐘形曲線的高度),$\Phi$ 是其累積分佈函數(由負無窮積分到某點的面積)。EI 閉式解中,$\Phi$ 加權於「均值拋離最佳值」的利用項,$\phi$ 加權於「標準差」的探索項,兩者皆由標準化距離 $(\mu_{n+1} - f_n^*)/\sigma_{n+1}$ 驅動。
EI 與 UCB 應如何取捨?
EI 的利用探索比重由後驗自動決定,開箱即用,是最常見的預設選擇;UCB 把比重交給使用者設定的 $\beta$,透明可控,但調錯 $\beta$ 會令搜索過於保守或過於飄忽。原片只介紹兩者結構,未有給出優劣結論;實務上常兩者都試,比較試點路徑是否合理。
貝葉斯優化找到的最佳參數可以直接上實盤嗎?
不可以直接這樣推論。BO 優化的是回測中的目標函數,若數據有倖存者偏差、成本假設失真或樣本期太短,「最優參數」只是對那段歷史最優。學術框架本身不處理這些數據問題,任何參數都應經過樣本外測試與穩健性檢查,本課內容亦不構成任何投資建議。
原影片
本文整理自以下影片,版權屬原創作者所有,建議配合原片觀看: