機器學習與配對交易 Pairs Trading:用 SVM、隨機森林、神經網絡預測價差
第 27 課・共 34 課
目錄
上一章我們用統計檢定與 Z-score 建立配對交易的基本框架,由本講(Liu Peng 課程第 12 講第 1 段)起正式進入機器學習 Machine Learning 章節。講者的切入點很實際:配對交易訊號的質素取決於價差預測的準繩度,而傳統移動平均只是一個相當樸素的預測器——機器學習模型正是用來取而代之的工具。本篇筆記按原片脈絡重構,由配對交易的成功要素講到 ML 模型的拆解、訓練與過度擬合。
學習重點
- 配對交易的成敗取決於三個部件:找到協整或高度相關的資產對、準確預測價差時間序列、配合適當風險管理
- 之前章節的移動平均其實扮演「價差預測器」角色,Z-score 就是實際價差與預測價差之差的標準化;機器學習的介入點正是取代這個樸素預測器
- 價差是連續變數,故任務屬於回歸;原片計劃探索 SVM、隨機森林與神經網絡三種算法,並以特徵工程擴充輸入
- 任何 ML 模型都可拆解為參數(權重)與架構兩部分;訓練就是以優化算法調參、令成本函數最小化的反饋循環
- 過度擬合是常態而非例外:模型複雜而數據有限時幾乎必然出現,須靠正則化令模型泛化到未見數據
詳細筆記
配對交易框架回顧
講者先重申配對交易 Pairs Trading 的結構:這是一種建構式(constructive)交易策略,涉及兩隻高度相關或協整 Cointegration 的資產,在同一時間、相反方向建倉。策略的核心假設只有一條——兩者價格之間的價差 Spread 呈現均值回歸 Mean Reversion 行為。市場偶有暫時錯價,令價差偏離長期均衡水平,但這種偏離是暫時的,長遠而言兩隻資產會回復同向而行,價差終將回到均值附近。正是這種「偏離—回歸」的循環,創造了生成交易訊號的機會。
數學上,設兩隻資產價格為 $P_t^A$ 與 $P_t^B$,價差一般寫成($\beta$ 為對沖比率):
$$S_t = P_t^A - \beta\, P_t^B$$策略的判斷邏輯是:當 $S_t$ 顯著偏離其均衡水平,便預期它會回歸,從而生成反向建倉的訊號。至於「均衡水平是多少」,正正是機器學習要回答的問題。
成功三要素:ML 的介入位置
講者把配對交易拆成三個決定成敗的部件,這是本講的骨架:
- 找到協整或高度相關的資產對:做法是對資產池內每一對候選組合逐一做統計檢定(例如協整與配對交易|第 23 課教過的 Engle-Granger 檢定),確認兩者存在長期均衡關係。這是配對選取階段,屬於統計學的地盤。
- 準確預測價差時間序列:這是訊號生成的核心,也是機器學習的介入點。回顧之前章節的做法:用移動平均 Moving Average 把每日價差標準化成 Z-score。講者點出一個容易被忽略的視角——那條移動平均線,其實就是我們對價差的「預測」。實際價差與預測價差相減,再除以標準差,便得到以標準差為單位的偏離程度:
其中 $\hat{S}_t$ 是移動平均給出的預測價差,$\sigma_t$ 是滾動標準差。Z-score 越極端,代表實際價差偏離預測越遠。問題在於:移動平均是一個非常樸素(naive)的預測器,它只看歷史平均,不懂任何規律。換上機器學習模型做預測,理論上可以得到更準確的 $\hat{S}_t$,訊號質素隨之提升。 3. 適當的風險管理:若價差朝不利方向持續擴大,虧損會不斷累積,因此策略通常設置止損 Stop Loss。講者提醒,即使前兩個部件做得再好,欠缺風險管理仍然會令策略在極端市況下受重創。
機器學習模型是甚麼
講者給機器學習模型下了一個功能性定義:它是一個函數,把一組給定的數據映射到一組預測。寫成數學形式:
$$\hat{y} = f(\mathbf{x}; \boldsymbol{\theta})$$其中 $\mathbf{x}$ 是輸入特徵,$\boldsymbol{\theta}$ 是模型參數,$\hat{y}$ 是預測輸出。在配對交易情境中,$\hat{y}$ 就是每日價差,而預測出來的價差序列隨後用於識別可圖利的交易訊號。
由於價差是連續數值,這個任務屬於回歸 Regression——即目標輸出是連續變數的預測問題(相對於輸出離散類別的分類問題)。講者宣布本章將探索三種回歸算法:
- 支持向量機 Support Vector Machine(SVM)
- 隨機森林 Random Forest(RF)
- 神經網絡 Neural Network
除了換模型,講者還提出另一條提升路徑:特徵工程 Feature Engineering,即擴充特徵空間。單以歷史價差序列作輸入之外,可以加入更多由歷史數據衍生的特徵(例如技術指標),讓模型掌握更豐富的資訊去學習價差的動態。
拆解一個機器學習模型
講者用一個直觀比喻:模型可以視為一件實物,有自己的大小與組件。任何機器學習模型都可拆解為兩個部分:
- 參數 Parameters(或稱權重 weights):模型的積木,是模型實際包含、可以調動的部件。
- 架構 Architecture:規定資訊如何組織的藍圖——輸入數據進來後,與哪些參數互動、互動的方式是相乘還是相加,最終如何匯集成輸出。
以最簡單的線性模型為例,$f(\mathbf{x}; \boldsymbol{\theta}) = \mathbf{w}^\top \mathbf{x} + b$,權重向量 $\mathbf{w}$ 與截距 $b$ 是參數,「輸入與權重相乘後求和再加截距」這條規則就是架構。神經網絡的架構遠為複雜,但拆解邏輯相同。
模型訓練 Model Training,就是調整這些參數的過程,目標是令模型產出良好的預測表現。講者強調表現要分兩處衡量:訓練集上自然要好,但更重要的是測試集——即模型從未見過的數據。訓練迭代進行時,演算法根據輸入數據不斷修正參數,訓練數據上的預測誤差會逐步下降。
過度擬合與正則化
訓練誤差下降並不保證成功。講者點出一個常見現象:過度擬合 Overfitting——模型在訓練集上表現極佳,在測試集上卻明顯變差,即模型把訓練數據背得滾瓜爛熟,卻學不到可推廣的規律。
過度擬合之所以普遍,是因為現代模型通常相當複雜:參數數量龐大、架構層層堆疊。當數據量不大而模型容量極高時,模型有足夠自由度把數據中的噪音也當成規律學進去,過度擬合幾乎是必然結果。
對策是施加適當的正則化 Regularization:在訓練目標中加入對參數規模的懲罰,令模型不再一味遷就訓練數據,從而保留泛化到未見數據的能力。以 L2 正則化為例,訓練目標由純誤差變成:
$$\min_{\boldsymbol{\theta}} \; \underbrace{\frac{1}{n} \sum_{i=1}^{n} \left( y_i - f(\mathbf{x}_i; \boldsymbol{\theta}) \right)^2}_{\text{預測誤差}} + \; \underbrace{\lambda \lVert \boldsymbol{\theta} \rVert^2}_{\text{複雜度懲罰}}$$前半項是均方誤差,量度預測與真實目標的距離;後半項按參數大小施罰,$\lambda$ 控制懲罰力度。模型被迫在「貼合數據」與「保持簡單」之間取捨,測試集表現因而有機會改善。
完整的訓練框架
講者以一張框架圖總結整個訓練流程,各部件環環相扣:
- 訓練數據:由輸入特徵與目標標籤組成(input features + target labels)
- 模型:由參數與架構構成,接收輸入後產出預測
- 成本函數 Cost Function:量度預測與目標標籤之間的距離,例如上面的均方誤差
- 優化算法 Optimization:以成本為反饋訊號,回頭微調模型——主要是調參數,架構通常預先固定
- 循環往復,直至成本收斂
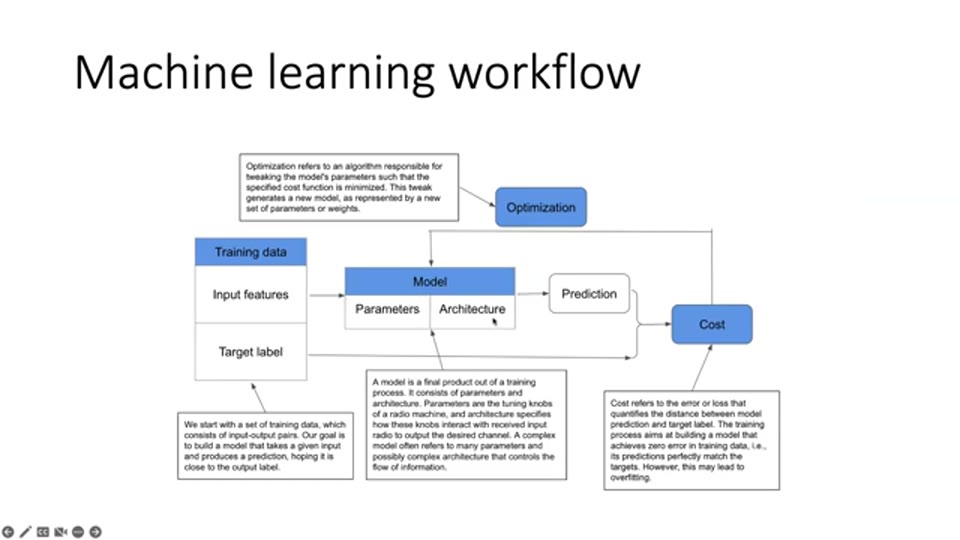
這個「預測 → 計成本 → 反饋調參」的循環適用於絕大部分監督式學習,不只神經網絡。理解這個框架後,之後章節逐一介紹 SVM、隨機森林與神經網絡時,分別只在於模型內部的參數形式與架構設計,外層的訓練邏輯完全一致。本講至此完成概念鋪墊,具體算法留待後續影片。
🙏 覺得內容有用?本站所有內容免費提供,使用推薦碼開戶就是支持我們繼續營運的最大鼓勵:
ZA Bank 邀請碼 P20923
—— 你享 HKD 2,000 迎新獎賞,本站獲得營運支持。
立即開戶 →
(聯盟連結|投資涉及風險,受條款及細則約束,此資料僅可於香港境內分發)
欣利克的看法
- 概念釐清:移動平均也是一種「模型」。講者把上一章的移動平均重新定位為價差預測器,這個視角很有啟發性。Z-score 的本質是「實際值減預測值」的標準化殘差,預測器越準,殘差越能反映真正的錯價而非預測誤差。由此可見,機器學習在這裏不是顛覆框架,而是替換框架內的一個零件——配對選取、風險管理兩個部件原封不動。
- 常見誤區:預測價差不等於預測升跌。價差預測服務於均值回歸邏輯:模型給出均衡水平的估計,交易訊號來自實際價差對它的偏離。這與直接預測資產價格方向的思路完全不同,後者要捕捉趨勢,前者反而假設價差終將回歸。讀後續章節時要分清:ML 在此回答的是「均衡在哪裏」,不是「市場往哪走」。
- 觀點比較:三種算法各有所長,原片未分高下。SVM 在小樣本、高維數據上表現穩健;隨機森林抗過度擬合能力較強且能輸出特徵重要性;神經網絡容量最大但最依賴數據量與調參。講者只列出探索清單,並無斷言何者最適合價差預測——金融時間序列信噪比極低,任何算法都須經嚴格樣本外驗證才有意義。
- 時效提醒:本片為大學課堂錄影,屬概念導論性質,三種算法的具體推導與實驗在後續影片展開。截至 2026 年中,SVM、隨機森林、神經網絡仍是機器學習入門的標準内容,但量化研究界亦廣泛採用梯度提升樹與深度時序模型等更新工具,本講內容宜視為基礎框架而非技術前沿。
名詞解釋
- 配對交易 Pairs Trading:同時做多一隻、做空另一隻相關資產的市場中性策略
- 協整 Cointegration:兩條非平穩價格序列的線性組合呈平穩的長期均衡關係
- 價差 Spread:兩資產價格經對沖比率調整後的差異,配對交易的交易對象
- 均值回歸 Mean Reversion:價格偏離均衡後傾向回歸的統計現象
- Z-score:以標準差為單位的偏離度,本課由實際價差減預測價差求得
- 支持向量機 Support Vector Machine:以最大邊界為原則的監督式算法,可配核函數處理非線性
- 隨機森林 Random Forest:多棵決策樹集成投票或取平均的抗過擬合算法
- 神經網絡 Neural Network:多層帶權重節點組成的模型,參數經反饋循環調整
- 特徵工程 Feature Engineering:由原始數據構造與篩選輸入變數、擴充特徵空間的工序
- 過度擬合 Overfitting:模型只遷就訓練數據、失效於未見數據的現象
- 正則化 Regularization:在訓練目標加入複雜度懲罰以抑制過度擬合的技術
- 止損 Stop Loss:價差朝不利方向擴大時限制虧損的風險管理機制
常見問題 FAQ
機器學習在配對交易中具體負責哪一步?
講者的拆解很清晰:配對交易有三個部件——用統計檢定尋找協整資產對、預測價差時間序列、風險管理。機器學習只介入第二個部件,取代移動平均這個樸素預測器,輸出更準確的預測價差 $\hat{S}_t$,令 Z-score 訊號更可靠。配對選取與止損機制維持原來的統計與風控方法。
為甚麼價差預測屬於回歸而非分類?
因為價差是連續數值——它可以是任何實數,而非「升/跌」這類離散類別。機器學習中,目標輸出為連續變數的任務稱為回歸(regression),輸出離散類別的稱為分類(classification)。本課要預測每日價差的具體水平,故選用 SVM、隨機森林、神經網絡的回歸版本。
模型的「參數」與「架構」有何分別?
參數是模型內可調動的數值(權重),訓練過程改變的正是它們;架構是模型的結構藍圖,規定輸入如何與參數互動(相乘、相加、經過多少層)以生成輸出。訓練時架構通常預先固定,優化算法只在參數空間內搜索。以線性模型為喻:$\mathbf{w}^\top \mathbf{x} + b$ 中 $\mathbf{w}$ 與 $b$ 是參數,「加權求和」這條規則是架構。
正則化能保證模型不會過度擬合嗎?
不能保證,只能降低風險。正則化透過懲罰參數規模,迫使模型在擬合數據與保持簡單之間取捨,改善泛化能力;但懲罰系數本身需要調校,設得太大會欠擬合、太小則形同虛設。況且金融數據信噪比極低,即使配合正則化,模型在樣本外的表現仍須獨立驗證,本課內容亦不構成任何投資建議。
原影片
本文整理自以下影片,版權屬原創作者所有,建議配合原片觀看: