SVM、隨機森林、神經網絡:三大機器學習模型原理與量化交易應用
第 28 課・共 34 課
目錄
承接上一課的配對交易機器學習框架,本講(Liu Peng 課程第 12 講第 2 段)逐一拆解三種核心算法:支持向量機 SVM、隨機森林 Random Forest 與神經網絡 Neural Network。講者的目標很清晰:理解每種模型的數學原理與超參數取捨,才知道在預測價差時該用哪一件工具、如何調校。
學習重點
- SVM 靠核函數把特徵映射到高維空間,再以「最大邊界」原則尋找分隔超平面;邊界最大化正是其泛化能力強、不易過度擬合的原因
- 回歸版本 SVR 引入 ε 不敏感損失:誤差在 ε 緩衝帶內不予計罰,ε 是模型複雜度與預測精度之間的關鍵取捨參數
- 隨機森林是集成模型:每棵決策樹用隨機抽選的數據子集與特徵子集訓練,最終預測取各樹平均,藉此降低子模型之間的相關性
- 神經網絡的基本單元是感知機:加權總和加偏置,再經激活函數作非線性轉換;訓練本質就是調校所有權重
- ReLU 是最流行的激活函數,勝在梯度計算快速兼能引入非線性,形式與認購期權的 payoff 函數相似
詳細筆記
支持向量機:核函數與最大邊界
講者指出,支持向量機 Support Vector Machine(SVM)是深度學習興起之前最廣泛使用的算法之一,在數據科學競賽社群尤其流行,因為它同時勝任分類與回歸任務,表現穩定而靈活。
SVM 的核心操作有兩步。第一步是映射:透過核函數 Kernel Function,把特徵由原始特徵空間映射到高維特徵空間。為何要這樣做?因為在原始空間中難以線性分隔的數據,升到高維後往往更容易找到一個能清楚分隔類別的超平面 Hyperplane。第二步是優化:在眾多可行超平面中,SVM 選擇令兩類數據之間邊界 Margin 最大的那一個。設超平面為 $\mathbf{w}^\top\mathbf{x} + b = 0$,兩側邊界到超平面的距離與 $\|\mathbf{w}\|$ 成反比,因此最大邊界問題可寫成:
$$\max_{\mathbf{w},\,b} \frac{2}{\|\mathbf{w}\|} \quad \text{等價於} \quad \min_{\mathbf{w},\,b} \tfrac{1}{2}\|\mathbf{w}\|^2$$講者強調,這個「最大邊界」原則正是 SVM 泛化表現好的根源:決策面與最近的數據點保持最大距離,模型對訓練數據的微擾不敏感,過度擬合 Overfitting 訓練集的風險自然降低,在測試集上的表現亦較穩定。
截圖出自原片(Liu Peng):SVM 以核函數映射數據,再按最大邊界原則尋找分隔超平面。
支持向量回歸:ε 不敏感損失
配對交易的目標變數是價差 Spread——一個連續變數——因此實務上用的是 SVM 的回歸版本,即支持向量回歸 Support Vector Regression(SVR)。此時超平面本身就是預測函數,任務變成:尋找一個盡量貼近實際數據的超平面,同時控制模型複雜度。
一般回歸以平方誤差和作成本函數:
$$\mathrm{SSE} = \sum_{i=1}^{n} \left( y_i - \hat{y}_i \right)^2$$但講者提醒,把 SSE 直接推向零是危險的——訓練誤差為零幾乎必然意味模型已把雜訊一併記住,即典型的過度擬合。SVR 的解法是引入 ε 不敏感損失 ε-insensitive Loss:只要預測誤差不超過 ε 這個緩衝帶,就不予計罰:
$$L_\epsilon(y, \hat{y}) = \max\left(0,\; |y - \hat{y}| - \epsilon\right)$$與此相關的幾個術語:位於超平面兩側、距離 ε 之內的數據點稱為支持向量 Support Vectors;由支持向量可畫出兩條距離超平面 ε 的決策邊界;兩條邊界之間是容忍區 Tolerance Zone,模型對區內誤差視而不見;落在邊界以外的點則構成邊界違規 Margin Violation,SVR 的優化目標正是把這些違規最小化。
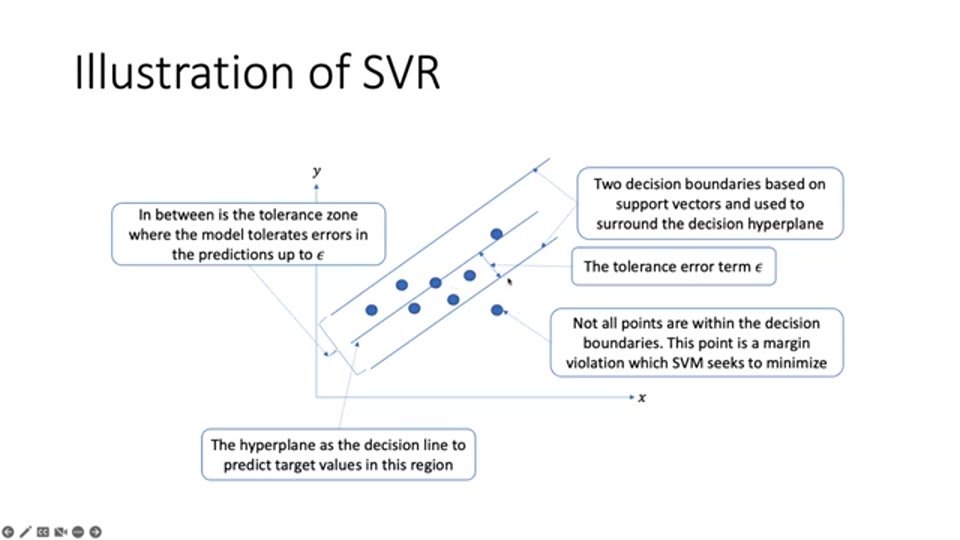
截圖出自原片(Liu Peng):SVR 的超平面、兩條決策邊界、ε 容忍區與邊界違規點。
ε 的取捨:複雜度與精度之間
ε 是一個由使用者在訓練前設定的超參數,講者稱之為容忍參數,其選擇直接決定模型的性格:
- ε 偏小:容忍區收窄,模型被迫貼近每個數據點,預測曲線變得迂迴曲折,走向過度擬合。
- ε 偏大:更多數據點落入容忍區,模型變得簡單平滑,極端情況下走向欠擬合 Underfitting;但配合適當正則化 Regularization,往往能換來較佳的泛化表現。
換言之,ε 是預測精度與模型複雜度之間的調節旋鈕。實務上的調校方法是以交叉驗證反覆試驗多個候選值,選取平均表現最好的一個——這與上一課講及的格點搜尋 Grid Search 思路一脈相承。
隨機森林:集成學習與隨機抽樣
第二種算法是隨機森林 Random Forest,屬於集成模型 Ensemble Model:由大量簡單的子模型——決策樹 Decision Tree——組合而成。每棵樹的訓練數據都經過雙重隨機抽樣:行方向隨機抽選觀測值,列方向隨機抽選特徵。舉例來說,原始數據集有 1000 個觀測、10 個特徵,第一棵樹可能只用隨機抽出的 100 個觀測和 5 個特徵來訓練,第二棵樹再重新抽一次,如此類推。這個過程稱為 bagging(bootstrap aggregation)。
最終預測取全體樹的平均(回歸)或多數投票(分類)。設第 $t$ 棵樹的預測為 $f_t(\mathbf{x})$,森林的輸出為:
$$\hat{y} = \frac{1}{T} \sum_{t=1}^{T} f_t(\mathbf{x})$$講者用了一個生動比喻:行政總裁手下有一班各自獨立工作的顧問,最終決策就是把各顧問的建議平均或投票得出。雙重隨機抽樣的用意正在於確保「顧問」之間的獨立性——各樹所用的數據子集與特徵子集不同,彼此的預測相關性低,平均之後方差下降,整體模型比任何單一決策樹更穩健。這正是集成學習「三個臭皮匠」的數學基礎:平均只在子模型夠獨立時才有效。
截圖出自原片(Liu Peng):隨機森林以 bagging 訓練多棵決策樹,取平均作最終預測。
神經網絡:由感知機出發
第三種算法是神經網絡 Neural Network,由多層互連的節點(神經元)組成。每個神經元是一個函數:接收上一層的輸入,執行非線性轉換,把輸出傳向下一層。每個神經元帶有一組權重,即網絡的參數;訓練神經網絡,本質上就是調校這些權重,令預測準確並能泛化到測試集。
網絡的基本單元稱為感知機 Perceptron,一個感知機完成兩步運算。第一步是加權總和:對 $p$ 維輸入 $\mathbf{x} \in \mathbb{R}^p$,各特徵乘上對應權重再求和,另加一個偏置 Bias(又稱截距)項,對加權總和作整體平移:
$$z = \sum_{i=1}^{p} w_i x_i + b = \mathbf{w}^\top \mathbf{x} + b$$講者補充,偏置可以理解為人工加入一列全為 1 的欄位再乘上權重 $b$,不過主流框架會自動處理。第二步是非線性轉換:把 $z$ 送入激活函數 Activation Function $\phi$,得到感知機的輸出:
$$f(\mathbf{x}) = \phi\left( \mathbf{w}^\top \mathbf{x} + b \right)$$ReLU:最常用的激活函數
眾多激活函數之中,ReLU 激活函數 Rectified Linear Unit(線性整流單元)最為流行,數學形式簡潔:
$$\phi(x) = \max(0, x) = \begin{cases} 0 & \text{若 } x \leq 0 \\ x & \text{若 } x > 0 \end{cases}$$它是一個閾值開關:輸入高於零時原值通過,低於零時靜音歸零。講者指出其形狀與認購期權的 payoff 函數如出一轍,對學過期權的讀者應不陌生。
ReLU 長期穩居首選的原因有二。其一是梯度計算快:神經網絡的訓練依靠在優化循環中反覆計算梯度來調校權重,激活函數的梯度越易算,訓練越快;ReLU 在正區間梯度恆為 1,負區間恆為 0,幾乎沒有計算成本。其二是引入非線性:這一點至關重要——如果整個網絡只做加權總和而不加非線性轉換,多層線性函數疊加起來仍等於一個線性模型,層數再多也無法擬合複雜關係。激活函數正是賦予網絡逼近能力的關鍵部件。ReLU 亦衍生出多種變體,但憑上述兩點優勢,至今仍是主流框架的預設選項之一。
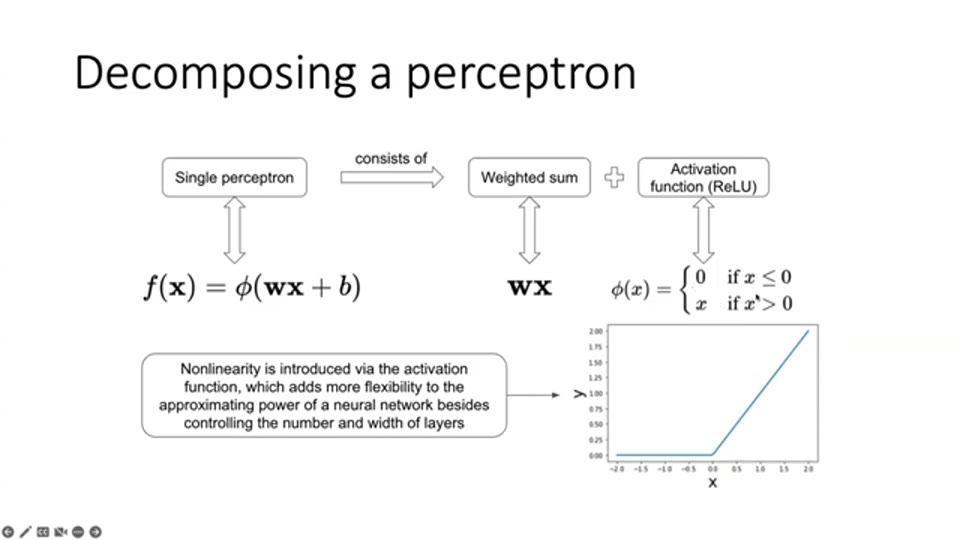
截圖出自原片(Liu Peng):感知機可拆解為加權總和加偏置,再經 ReLU 作非線性轉換。
三種模型的定位小結
講者沒有明示優劣排名,但由原片脈絡可整理出三者的分工:SVM/SVR 在中小樣本上表現穩定,核函數處理非線性的能力強,但 ε、核函數等超參數須仔細調校;隨機森林對特徵縮放不敏感、抗過度擬合能力好,訓練可大規模並行,代價是模型體積與可解釋性;神經網絡表達能力最強、可堆疊成深層架構,但參數量龐大,對數據量與調參經驗要求最高。在配對交易預測價差的場景中,三者都是可行的候選,後續章節將進入實作與比較。
🙏 覺得內容有用?本站所有內容免費提供,使用推薦碼開戶就是支持我們繼續營運的最大鼓勵:
ZA Bank 邀請碼 P20923
—— 你享 HKD 2,000 迎新獎賞,本站獲得營運支持。
立即開戶 →
(聯盟連結|投資涉及風險,受條款及細則約束,此資料僅可於香港境內分發)
欣利克的看法
- 概念釐清:SVM 的「支持向量」不是全部數據。 初學者常誤以為 SVM 用上所有訓練點做決策,實際上決策面只由邊界附近的少數支持向量決定,其餘點刪掉也不影響結果。理解這一點,才明白為何 SVM 對遠離邊界的離群值相對不敏感。
- 常見誤區:ε 不是越小越準。 ε 收窄確實令訓練誤差下降,但那是以模型複雜度為代價換來的。訓練集上「更準」往往意味着測試集上「更差」,講者建議以交叉驗證選 ε,正是為了用樣本外表現而非樣本內表現做標準。
- 概念釐清:隨機森林的「隨機」有明確目的。 雙重隨機抽樣不是為了省計算,而是為了製造子模型之間的獨立性。平均能降方差的前提是各樹預測誤差低度相關;若所有樹都用同一批數據,集成便失去意義。
- 觀點比較:非線性的兩條路線。 SVM 用核函數在高維空間找線性解,神經網絡則用激活函數逐層堆疊非線性,兩者殊途同歸,都是為了突破線性模型的表達限制。比較兩條路線有助理解:核方法的數學較優雅,神經網絡的擴展性較強。
- 時效提醒: 本片屬模型原理的入門導論,未有涉及具體調參細節與實證比較;截至 2026 年,深度學習在金融時間序列上的應用已遠超本片範圍,但三者仍是理解後續方法的必要基礎。
名詞解釋
- 支持向量機 Support Vector Machine:以最大邊界原則尋找決策超平面的監督式算法,配合核函數可處理非線性關係,回歸版本稱為 SVR
- 核函數 Kernel Function:把數據由原始特徵空間映射到高維空間的函數,令非線性問題在高維中變得線性可分
- 隨機森林 Random Forest:由多棵決策樹組成的集成模型,各樹以隨機子集訓練,取平均或多數投票作最終預測
- 神經網絡 Neural Network:由多層神經元互連組成的模型,訓練本質是調校各神經元的權重以最小化預測誤差
- 感知機 Perceptron:神經網絡的基本單元,先計算加權總和加偏置,再經激活函數作非線性轉換
- ReLU 激活函數 Rectified Linear Unit:輸入為正時原值輸出、為負時歸零的激活函數,梯度計算快,是神經網絡的主流選擇
- 過度擬合 Overfitting:模型把訓練數據的雜訊一併記住,樣本內表現極佳但無法泛化到未見數據
- 正則化 Regularization:在成本函數中加入懲罰項以約束模型複雜度,提升泛化能力的技術
常見問題 FAQ
SVM 和 SVR 有什麼分別?
兩者是同一算法的分類與回歸版本。分類版 SVM 尋找能以最大邊界分隔不同類別的超平面;回歸版 SVR 則把超平面直接用作預測函數,並引入 ε 不敏感損失——誤差在 ε 緩衝帶內不予計罰,藉此避免把平方誤差推向零而導致過度擬合。配對交易預測連續的價差水平,用的正是 SVR。
隨機森林為什麼要對數據和特徵雙重隨機抽樣?
目的是確保各決策樹之間的獨立性。如果所有樹都用相同的數據和特徵訓練,它們的預測會高度相關,平均之後無法降低方差,集成便形同虛設。雙重隨機抽樣(bagging)令各樹看到不同的「局部世界」,預測誤差低度相關,平均後整體模型才比單一決策樹更穩健。
神經網絡沒有激活函數會怎樣?
會退化成一個線性模型。多層線性運算(加權總和)疊加起來,數學上仍等價於單層線性變換,無論疊多少層都無法擬合非線性關係。激活函數(如 ReLU)在每層引入非線性轉換,正是神經網絡強大表達能力的來源。
ReLU 為什麼是最流行的激活函數?
主要有兩個原因。第一,梯度計算極快:ReLU 在正區間梯度恆為 1、負區間恆為 0,令反向傳播的優化循環效率大增。第二,它以極簡形式引入非線性,且形狀類似認購期權的 payoff 函數——輸入高於閾值時原值通過,低於閾值時歸零。ReLU 還有多種變體可應對不同訓練問題。
原影片
本文整理自以下影片,版權屬原創作者所有,建議配合原片觀看: