配對交易實作實驗課:用 Python 由協整檢定到回測逐步實現 Pairs Trading
第 29 課・共 34 課
目錄
理論課講過配對交易 Pairs Trading 的概念,本課是配套的實驗課(lab):講者 Liu Peng 在 Google Colab 上用 Python 把整套配對交易流程實作出來——由平穩性檢定、協整選股、Z 分數訊號到回測計算,逐格代碼運行示範。本篇筆記按實作順序重構整理,公式用 LaTeX 重寫,代碼只摘錄關鍵段落。
學習重點
- 用 ADF 檢定區分平穩與非平穩序列,理解「均值、方差不隨時間改變」的定義
- 用 OLS 線性回歸求兩隻股票的價差(殘差),再對價差做協整檢定
- 協整與相關是兩回事:相關系數 0.99 的序列未必協整
- 用滾動窗口把價差標準化成 Z 分數,設進場/出場雙門檻生成訊號
- 回測時倉位必須滯後一日,避免用今天的訊號賺今天的錢(前視偏差)
詳細筆記
第一步:數據準備與平穩性概念
實作環境是 Google Colab。講者先安裝 yfinance 以便下載股票價格數據,再導入 statsmodels 的 ADF 檢定與 OLS 回歸模組——這兩個工具貫穿全課。
實驗由最基本的問題開始:一個時間序列要具備甚麼性質,配對交易才成立?答案是平穩性 Stationarity。講者用三條模擬序列示範:第一條每次從同一個標準正態分佈 $N(0, 1)$ 抽樣一百次,是平穩序列;第二條每次抽樣時把均值逐步調高,第三條連標準差也逐步放大(第 $i$ 次抽樣的標準差為 $\sqrt{i}$),兩者皆非平穩。畫成折線圖後分別一目瞭然——平穩序列圍繞固定水平窄幅波動,非平穩序列的均值會漂移、波幅會越滾越大。
平穩的定義是:序列背後分佈的參數(均值 $\mu$、標準差 $\sigma$)不隨時間改變。檢驗工具是 ADF 檢定 Augmented Dickey-Fuller Test,其回歸形式為:
$$\Delta y_t = \alpha + \beta t + \gamma y_{t-1} + \sum_{i=1}^{p} \delta_i \Delta y_{t-i} + \varepsilon_t$$原假設是 $\gamma = 0$(存在單位根、非平穩)。實作上只需把序列丟進 adfuller 函數取 p 值:p 值小於顯著水平(講者用 5%)便拒絕原假設,視為平穩。三條模擬序列的檢定結果與設計完全吻合——第一條通過,其餘兩條不通過。
第二步:用 OLS 求價差,檢定協整
進入真實數據。講者用 yfinance 下載 Google 與 Microsoft 2022 年全年的經調整收市價(adjusted close),然後建立簡單線性回歸:
其中 $Y$ 是 Google 價格、$X$ 是 Microsoft 價格。留意代碼中的 add_constant:不加常數項,回歸線會被強行穿過原點,估計出來的 $\beta$ 會失真,這是初學者用 statsmodels 最常漏掉的一步。用 普通最小平方法 OLS 估計 $\hat\alpha$ 與 $\hat\beta$ 後,價差 Spread 就是殘差:
Y = df[stocks[0]]                     # 目標變數
X = sm.add_constant(df[stocks[1]])    # 解釋變數加常數項
model = sm.OLS(Y, X).fit()            # OLS 估計
residuals = Y - model.predict(X)      # 殘差即價差
(以上代碼摘錄自原片教學。)
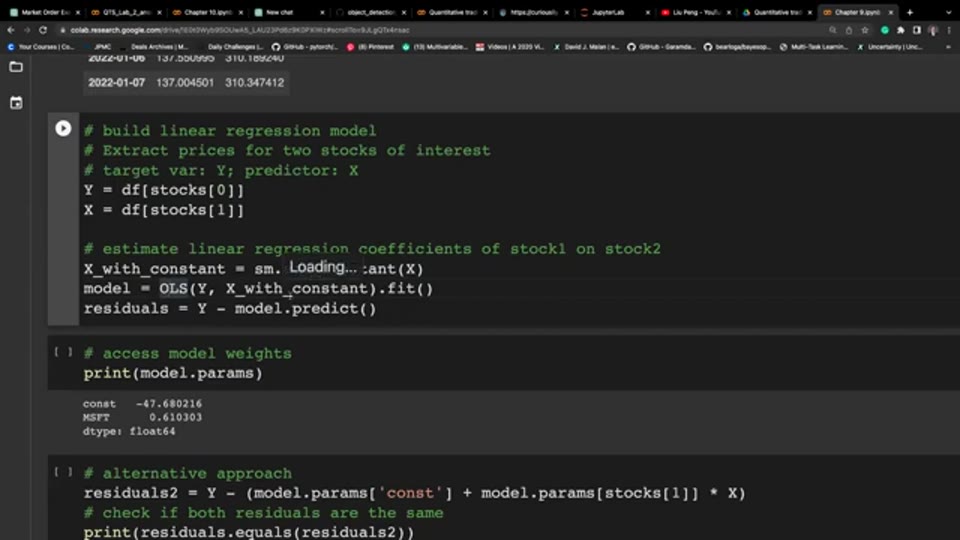
講者還示範了驗算:把 $\hat\alpha + \hat\beta X_t$ 逐日計出再與 $Y_t$ 相減,結果與 model.predict 的殘差完全一致——這步看似多餘,實際是建立「殘差=價差」的直覺:回歸線是兩股的「合理關係」,殘差就是偏離合理關係的幅度。之後對殘差做 ADF 檢定,輸出 t 統計量與 p 值,該時段的檢定結果顯示兩股協整——價差序列平穩,具備均值回歸的統計基礎。
第三步:協整 ≠ 相關
這是全課最重要的概念釐清。講者刻意構造兩條序列:同一正態分佈、不同均值、同樣標準差,各自取累積和。畫出來兩線同步向上,相關系數高達 0.99;但做協整檢定,p 值卻不顯著——它們並不協整。
原因在定義:相關系數量度的是兩序列變動的線性同向程度,兩條各自帶趨勢的序列可以高度相關,其差距卻持續擴大、永不回歸。配對交易需要的是「價差會被拉回來」的性質,只有協整 Cointegration 檢定能驗證這點。用相關系數選股做配對交易,是新手最常見的陷阱。講者特別提醒:兩個概念的定義不同、計算方法不同,結論自然可以相反。
第四步:批量篩選協整股對
實戰不可能逐對肉眼檢查。講者用六隻科技股(GOOG、MSFT、AAPL、TSLA、META、NFLX)示範:用 itertools.combinations 生成所有不重複的股對組合,逐對用 statsmodels 的 coint 函數做 Engle-Granger 協整檢定、抽出 p 值,門檻放寬至 10%(比慣用的 5% 寬鬆)。結果只有 Google 與 Microsoft 通過——六隻股票十五個組合,只有一對可用,這也說明協整關係在真實市場並不常見,盲目對所有「看似同業」的股票開倉並無統計依據。
第五步:Z 分數標準化與訊號生成
選定股對後,重複 OLS 步驟取得日度價差。原始價差的問題是單位與尺度因股而異,難以判斷「偏離多大才算大」。解法是Z 分數 Z-score 標準化,用滾動窗口(講者用 10 日)估計均值與標準差作基準:
$$z_t = \frac{s_t - \mu_t}{\sigma_t}$$window_size = 10
spread_mean = spread.rolling(window_size).mean()
spread_std = spread.rolling(window_size).std()
zscore = (spread - spread_mean) / spread_std
(以上代碼摘錄自原片教學。)
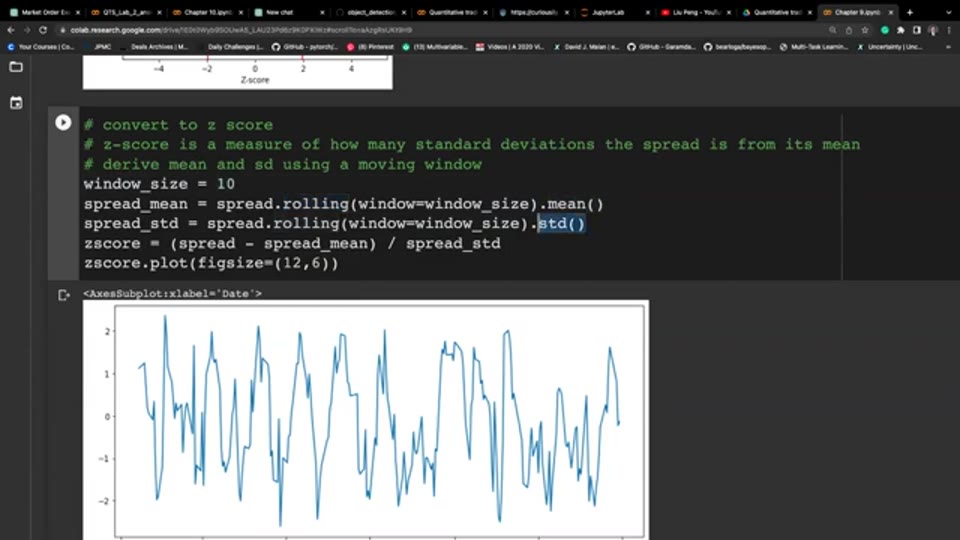
Z 分數的直觀意義:當前價差偏離滾動均值多少個標準差。講者特意補了一張正態分佈鐘形曲線圖:曲線下左右兩端各 2.5% 的陰影面積對應 $\pm 1.96$ 個標準差,合計 5%——這正是假設檢定中「p 值小於 5% 便拒絕原假設」的幾何意義,也把檢定邏輯與交易門檻連起來:偏離超過約兩個標準差屬小概率事件,值得視為「異常」而非「噪音」,正是進場時機。滾動均值與標準差亦可理解為對價差中軸與波幅的動態預測,基準會隨市況移動,比用全期固定均值更貼近實戰。
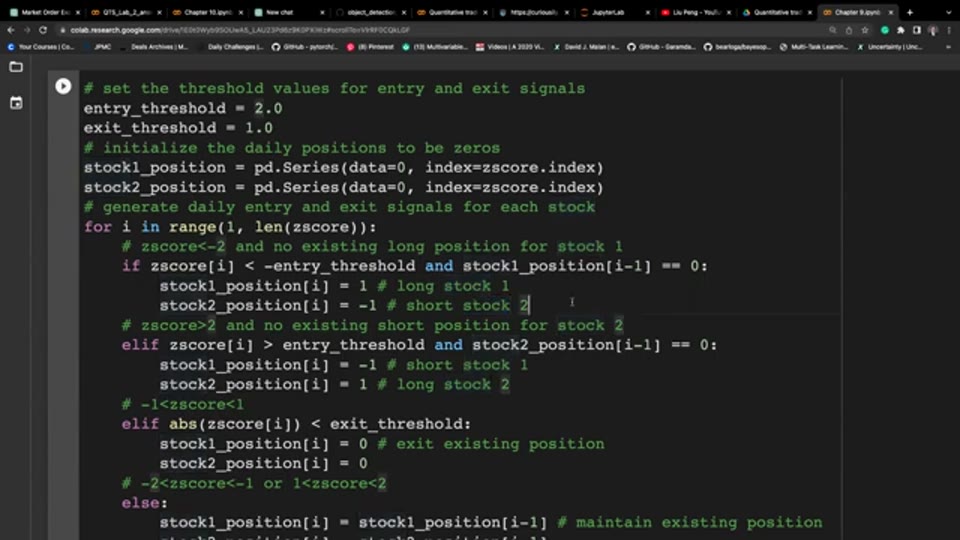
訊號規則設兩個門檻:進場 2.0、出場 1.0。為何兩個門檻而非一個?若進出場共用同一條線,價差在門檻附近小幅震盪便會令倉位反覆開平,交易成本與訊號噪音都會大增;把出場線收在進場線之內,形成一個「緩衝帶」,持倉期間價差小幅反覆也不會被掃出場。邏輯如下:
- $z_t < -2$ 且無持倉:股票一被低估、股票二被高估 → 買入股票一(+1)、沽空股票二(−1)
- $z_t > 2$ 且無持倉:反向操作 → 沽空股票一、買入股票二
- $|z_t| < 1$:價差收斂回歸中軸 → 平倉離場,倉位歸零
- 其餘情況(介乎進場與出場門檻之間):維持前一日倉位不變
實作上用兩個 Series 分別記錄兩股每日倉位,for 迴圈逐日按上述條件更新;「維持倉位」就是直接把前一日的倉位值複製過來。由於滾動窗口的關係,最初十日的 Z 分數是空值,需從首個有效日期開始計算。
第六步:回測與累計回報
回測計算有一個關鍵細節:倉位必須 .shift(1) 滯後一日。今日收市後才計出的訊號,最早明天才能成交,用今日倉位乘今日回報就是前視偏差 Look-ahead Bias。每隻股票的策略回報為:
講者的做法是:先對兩股價格取 pct_change 得出日度簡單回報,再乘以上一日的倉位(+1 長倉、−1 短倉、0 無倉),短倉在跌市中自然錄得正回報;這與趨勢策略的損益計法一致。兩股回報相加、缺失值補零,再複利累積:
stock1_returns = df["GOOG"].pct_change() * stock1_position.shift(1)
stock2_returns = df["MSFT"].pct_change() * stock2_position.shift(1)
total_returns = (stock1_returns + stock2_returns).fillna(0)
cumulative_returns = (1 + total_returns).cumprod()
(以上代碼摘錄自原片教學。)
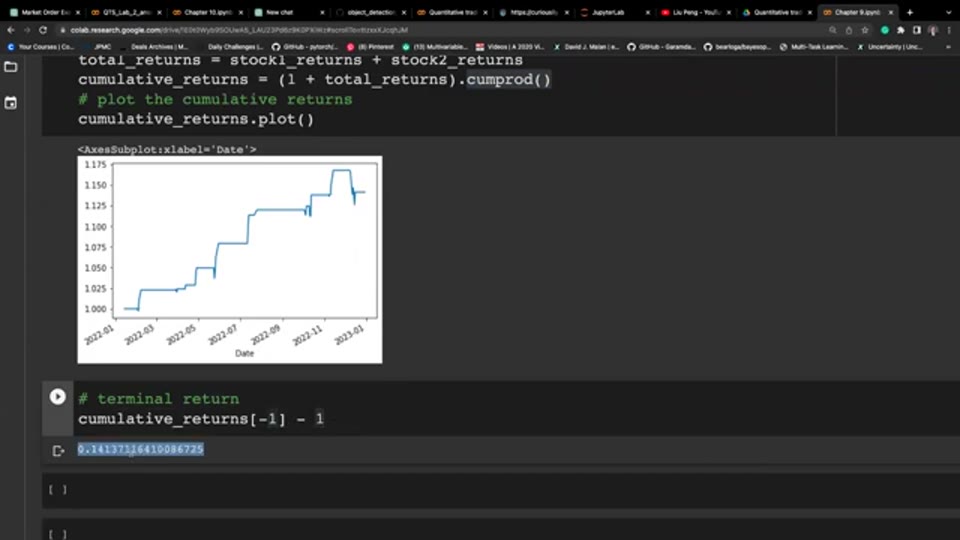
該時段(2022 年全年)回測終值約 14%。留意 2022 年科技股大幅波動,價差多次觸及進場門檻,這類市況對均值回歸策略相對有利;換一個平靜單邊的年份,結果可以完全不同。講者特別強調:這裏有大量簡化假設——無手續費、無滑點、沽空成本為零、成交價即收市價。教學目的是示範流程,不是證明策略必然賺錢。
🙏 覺得內容有用?本站所有內容免費提供,使用推薦碼開戶就是支持我們繼續營運的最大鼓勵:
ZA Bank 邀請碼 P20923
—— 你享 HKD 2,000 迎新獎賞,本站獲得營運支持。
立即開戶 →
(聯盟連結|投資涉及風險,受條款及細則約束,此資料僅可於香港境內分發)
欣利克的看法
實驗課與理論課的呼應:本 lab 是第 23 講協整檢定的動手版。理論課講 Engle-Granger 兩步法的推導,這裏直接用
OLS加adfuller兩行代碼實現。建議先讀理論再看實作,否則容易只記住函數名,不理解 p 值背後的原假設邏輯。與 Saleh 實作課的對照:Saleh 的配對交易課用 Jesse 框架實盤化,計入手續費後 69% 回報變成虧損;本課是學術教學版,完全不計成本,得出約 14%。兩者正好示範「回測數字對假設極度敏感」:同一策略邏輯,成本假設一變,結論可以反轉。
常見誤區:把相關當協整。課中 0.99 相關卻不協整的例子值得反覆看。另外 Z 分數用滾動窗口是雙刃劍——窗口太短基準不穩、太長反應遲鈍,10 日只是示範值,並無理論根據證明它最優。
實作與理論的落差:講者自己點明假設清單——零手續費、零滑點、即時成交、可無限沽空。還有一個教學沒提的問題:協整檢定用全期數據選股,回測又在同一時段進行,存在樣本內偏差。截至 2023 年原片發佈時的數據與工具版本均可能過時,重現結果或有出入。
.shift(1)那一行是全課靈魂:初學者寫回測最常犯的錯就是用當日訊號計當日損益。養成「訊號必滯後」的習慣,比學任何新策略都重要。
名詞解釋
- 配對交易 Pairs Trading:同時買入被低估一方、沽空被高估一方的市場中性策略
- 協整 Cointegration:兩個價格序列的線性組合長期穩定的性質
- 平穩性 Stationarity:時間序列的均值與方差不隨時間改變的性質
- ADF 檢定 Augmented Dickey-Fuller Test:檢驗序列是否平穩的單位根測試
- 普通最小平方法 Ordinary Least Squares:以最小化殘差平方和估計回歸參數的方法
- Z 分數 Z-score:偏離均值有多少個標準差的標準化量度
- 價差 Spread:兩個相關標的價格的差距,配對交易的交易對象
- 統計套戥 Statistical Arbitrage:利用統計關係失效與回歸獲利的策略統稱
- 回測 Backtesting:用歷史數據模擬策略表現的驗證方法
- 前視偏差 Look-ahead Bias:回測中誤用當時不可得的資訊造成的失真
常見問題 FAQ
為甚麼配對交易要用協整檢定,不能只看相關系數?
相關系數只量度兩序列變動的同向程度,兩條各自帶趨勢的序列可以相關極高、價差卻持續擴大永不回歸。協整檢定驗證的是價差序列本身是否平穩——即偏離後會被拉回均值,這才是配對交易賴以成立的性質。原片用相關 0.99 卻不協整的模擬例子清楚示範了兩者差異。
Z 分數的進場門檻 2.0 是怎樣定出來的?
講者用的是直觀選擇:標準化後偏離兩個標準差,對應正態分佈約 5% 的尾部概率,屬小概率事件,故視為價差「異常擴大」的進場時機;出場門檻 1.0 則代表價差已收斂近半。這兩個數字是教學示範值,不同窗口長度與門檻組合會得出不同結果,需自行測試而非照抄。
為甚麼回測時倉位要滯後一日?
因為今日收市價計出的訊號,最早只能明日成交。若用今日倉位乘以今日回報,等於假設你能用收市後才知道的資訊在收市前落盤,這是前視偏差,會令回測結果系統性偏高。正確做法是 position.shift(1),用昨日收市確定的倉位計算今日損益。
原片回測約 14% 回報代表策略有效嗎?
不代表。該數字基於大量簡化假設:無手續費、無滑點、零沽空成本、以收市價即時成交,而且協整檢定與回測用同一時段數據,存在樣本內偏差。講者亦明言這只是流程示範。教學價值在於學懂由檢定到回測的完整 pipeline,而非該數字本身。
原影片
本文整理自以下影片,版權屬原創作者所有,建議配合原片觀看: