投資組合管理 Portfolio Management:均值-方差優化與兩階段決策框架
第 32 課・共 34 課
目錄
投資組合管理 Portfolio Management 是量化金融的核心課題:面對多項資產,資金應該如何分配?本講 Liu Peng 由最基礎的價格與回報出發,逐步推導出均值-方差優化(Mean-Variance Optimization, MVO)的目標函數,並點出「先預測、後優化」這個兩階段框架的局限與最新研究方向。本篇筆記按原片脈絡重構,公式以 LaTeX 重寫。
學習重點
- 投資組合管理包含兩個環節:預測(估計資產未來回報)與優化(決定每項資產的權重)
- 分析對象是回報而非價格:簡單回報是隨機變數,以預期回報與方差兩個矩刻畫
- 組合層面的回報是權重加權平均 $\mathbf{w}^\top \mathbf{r}$,風險則由協方差矩陣給出 $\mathbf{w}^\top \Sigma \mathbf{w}$
- 均值-方差優化的目標函數:最大化「回報減去風險懲罰」$\max_{\mathbf{w}} \; \mathbf{w}^\top \boldsymbol{\mu} - \lambda\, \mathbf{w}^\top \Sigma \mathbf{w}$
- 傳統做法是預測與優化分離的兩階段流程;前沿研究方向 Smart Predict-then-Optimize(SPO)嘗試把兩者合而為一
詳細筆記
投資組合管理的兩個核心環節
講者開宗明義指出,投資組合管理通常涉及兩個部分。第一部分是預測 Prediction:我們需要預測資產價格(更準確地說是回報)的走向。第二部分是優化 Optimization:在預測的基礎上,對決策變數——即分配給每項資產的權重——進行優化。整個框架的思考順序是「先有估計、後做配置」,這條主線貫穿全講。
由價格到回報:簡單回報與隨機變數
設某項資產(例如一隻股票)在時間 $t$ 的價格為 $S_t$。把價格沿時間軸畫出來,就是一條上上落落的時間序列。然而,衡量表現時我們一般不直接看價格,而是看回報——當期價格相對上期的百分比變化,稱為簡單回報 Simple Return:
$$r_t = \frac{S_t - S_{t-1}}{S_{t-1}}$$投資組合管理的問題在於:我們面對的不是一項資產,而是多項資產。設有 $N$ 項資產,每期我們觀察到一個回報向量:
$$\mathbf{r} = (r_1, r_2, \dots, r_N)^\top$$講者說明,為了書寫簡潔,這裡省略了時間下標 $t$,但要記住每一期都會觀察到一個這樣的向量。
關鍵的一步是:每個 $r_i$ 都是隨機變數 Random Variable。它不是固定數字,而是會變動的量,服從某個分佈——通常建模為常態分佈。講者亦提到一個技術細節:嚴謹的做法其實是對對數回報 Log Return 建模,但本講先略過這些細節。既然是隨機變數,未來的回報就無法直接觀察,必須先預測,然後才能做優化——這正是預測環節存在的原因。
權重向量與投資約束
面對 $N$ 項資產,我們的決策是給每項資產分配一個權重,組成權重向量:
$$\mathbf{w} = (w_1, w_2, \dots, w_N)^\top$$例如 $w_1 = 0.1$、$w_2 = 0.2$,如此類推。權重附带兩個典型約束。第一是全投資約束:假設資金全部投入組合,所有權重相加必須等於一。第二是禁止沽空:不允許借入資產沽出,因此每個權重必須為正數或零。合起來寫成:
$$\sum_{i=1}^{N} w_i = 1, \qquad w_i \geq 0 \quad (i = 1, \dots, N)$$這組約束定義了決策變數 $\mathbf{w}$ 的可行範圍。我們的任務,就是在這個範圍內找出一個權重向量,作為每項資產的配置決策。
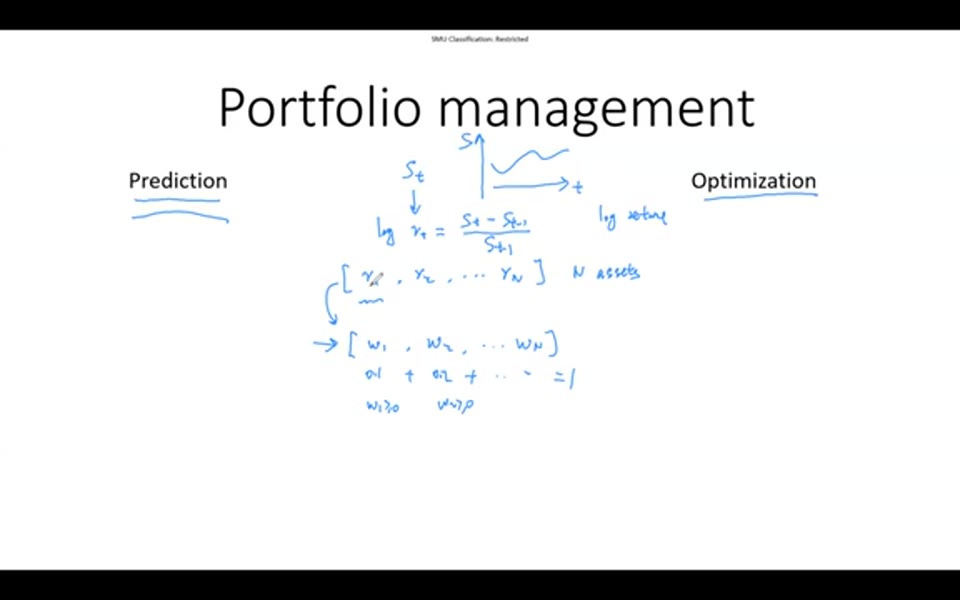 由回報向量 $[r_1, \dots, r_N]$ 到權重向量 $[w_1, \dots, w_N]$,權重相加等於一且不得為負。截圖出自原片(Liu Peng)
組合層面的回報與風險
要由個別資產的回報走到配置決策,先要回答一個問題:如何把所有資產的表現聚合到組合層面?講者指出,我們關心的是兩件事——回報 Return 與風險 Risk,兩者都要在組合層面計算。
回報方面,最自然的做法是把每項資產的回報按權重加權平均:
$$R_p = \sum_{i=1}^{N} w_i r_i = \mathbf{w}^\top \mathbf{r}$$右邊是向量寫法:權重向量的轉置乘上回報向量,結果是一個純量。這個數字我們希望最大化。
風險方面,首先要引入協方差矩陣 Covariance Matrix。這是一個 $N \times N$ 的矩陣 $\Sigma$,描述每對資產之間的共同變動:對角線元素是各資產自身的方差,非對角線元素則刻畫不同資產回報之間的協方差(即相關程度)。有了權重與協方差矩陣,組合層面的風險——即組合方差——由二次型給出:
$$\sigma_p^2 = \mathbf{w}^\top \Sigma \mathbf{w}$$同樣地,這是一個純量,我們希望最小化。注意風險之所以不是各資產方差的簡單加權,正是因為協方差矩陣的非對角線元素:資產之間的聯動關係會改變整體風險,這也是分散投資的數學根源。
均值-方差優化的目標函數
現在我們手上有兩個目標:最大化回報 $\mathbf{w}^\top \mathbf{r}$,同時最小化風險 $\mathbf{w}^\top \Sigma \mathbf{w}$。典型的做法是引入一個標量參數 $\lambda$,把兩個目標連結起來——在回報項之後減去風險項:
$$\max_{\mathbf{w}} \; \mathbf{w}^\top \boldsymbol{\mu} - \lambda\, \mathbf{w}^\top \Sigma \mathbf{w}$$由於風險要最小化,它帶負號進入目標函數;$\lambda$ 是正常數,控制風險懲罰的力度。整個式子的意思是:最大化經風險調整後的回報,而決策變數是 $\mathbf{w}$——我們要搜尋令這一項最大的權重向量。講者指出,這個框架就是著名的均值-方差優化 Mean-Variance Optimization(MVO),由 Markowitz 提出,在投資組合管理中應用極廣。
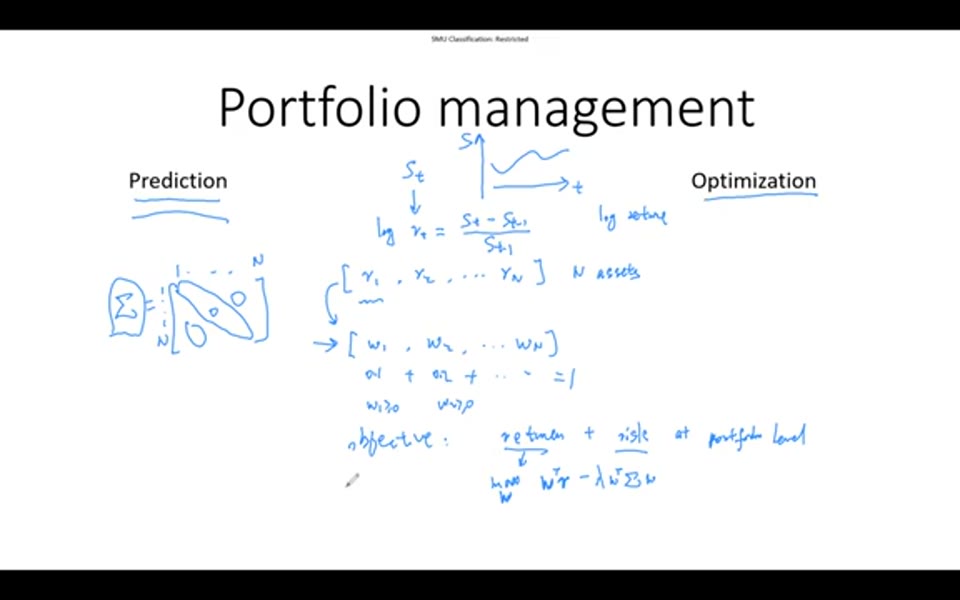 左方為 $N \times N$ 協方差矩陣,右下為 MVO 目標函數 $\max_{\mathbf{w}} \; \mathbf{w}^\top \mathbf{r} - \lambda\, \mathbf{w}^\top \Sigma \mathbf{w}$。截圖出自原片(Liu Peng)
預測環節:兩個必須估計的量
細看目標函數,$\mathbf{w}$ 是我們可以調校的變數,但另外兩項必須事先固定:預期回報向量 $\boldsymbol{\mu}$ 與協方差矩陣 $\Sigma$。回到隨機變數的框架:每項資產的回報 $r_i$ 是隨機變數,它的預期回報 Expected Return 是期望值,方差 Variance 是二階矩:
$$\mu_i = \mathbb{E}[r_i], \qquad \sigma_i^2 = \mathrm{Var}(r_i)$$均值與方差正是分佈的首兩個矩,它們概括了每項資產「回報有多高」與「波動有多大」。問題在於:$\boldsymbol{\mu}$ 與 $\Sigma$ 代表的是未來的預期回報與協方差,現實中我們無法取得,只能用預測值代替。於是目標函數實際操作時變成:
$$\max_{\mathbf{w}} \; \mathbf{w}^\top \hat{\boldsymbol{\mu}} - \lambda\, \mathbf{w}^\top \hat{\Sigma} \mathbf{w}$$戴上「帽」的 $\hat{\boldsymbol{\mu}}$ 與 $\hat{\Sigma}$ 是由歷史數據或預測模型得出的估計量。這就是兩階段框架的全貌:第一階段預測資產回報與協方差矩陣,第二階段把預測值固定,代入 MVO 公式做優化,搜尋最優的 $\mathbf{w}$。
兩階段框架的局限與 Smart Predict-then-Optimize
講者特別強調,這兩個階段是分離的:預測時我們不知道接下來的優化會如何使用這些估計,優化時亦沒有關於預測好壞的前瞻資訊。預測環節的目標是「估計得準」,但估計得準不等於配置決策做得好。
針對這個割裂,學術界有一個研究方向叫 Smart Predict-then-Optimize(SPO),中文可譯作「智能預測後優化」。「智能」之處在於把預測與優化放在同一個階段一併考慮:由輸入 $x$(例如歷史價格)出發,預測模型(由參數 $\beta$ 刻畫)產生 $\hat{\boldsymbol{\mu}}$ 與 $\hat{\Sigma}$,代入優化得出決策 $\mathbf{w}^*$;然後把這個決策與真實回報下的理想決策比較,得出決策誤差 Decision Error,並把誤差回饋到預測環節,反過來調整參數 $\beta$。換言之,目標不再是「做出好預測」,而是「做出令決策最優的預測」。講者形容這是一個令人興奮的研究領域,因為它把兩階段問題合併為一體,值得深入思考。
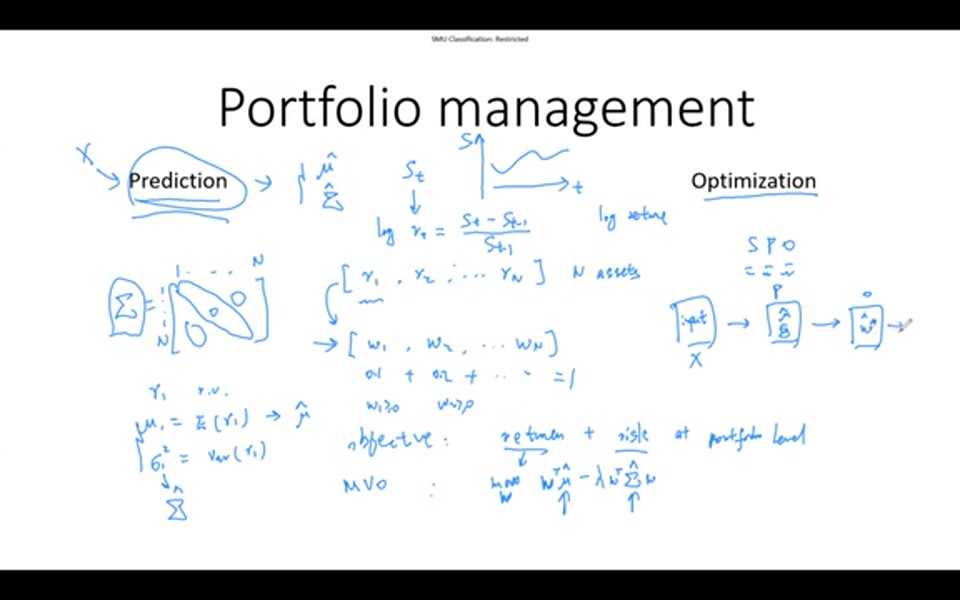 黑板全貌:左側是預測環節與隨機變數的矩,下方是 MVO 公式,右側是 SPO 把預測、優化與誤差回饋串成單一流程。截圖出自原片(Liu Peng)
🙏 覺得內容有用?本站所有內容免費提供,使用推薦碼開戶就是支持我們繼續營運的最大鼓勵:
ZA Bank 邀請碼 P20923
—— 你享 HKD 2,000 迎新獎賞,本站獲得營運支持。
立即開戶 →
(聯盟連結|投資涉及風險,受條款及細則約束,此資料僅可於香港境內分發)
欣利克的看法
- 權重對輸入極度敏感,這是 MVO 最著名的實務弱點。 均值-方差優化在紙上漂亮,但預期回報 $\hat{\boldsymbol{\mu}}$ 只要有一點估計偏差,優化器便可能給出極端的權重配置。學術文獻中常見的補救方法包括收縮估計(shrinkage)、加入權重上下限、或改用穩健優化(robust optimization),初學者宜先意識到這個敏感性的存在。
- 常見誤區:以為「預測準」等於「賺到錢」。 本講的兩階段框架正好揭示這個誤區——預測環節追求的統計準確度(例如最小化均方誤差),與最終關心的投資決策品質並非同一件事。SPO 的出現,正是學界對這個錯配(misalignment)的正式回應。
- 方差作為風險度量有其假設,宜與其他度量比較理解。 MVO 把風險等同於方差,即對上行與下行波動一視同仁;但不少投資者真正在意的是下行虧損。因此學術與業界亦發展出以半方差、VaR 或 CVaR 為風險項的優化框架,可作為 MVO 的對照來學習。
- $\lambda$ 不是技術細節,而是主觀偏好的量化。 同樣的預測輸入,不同的風險厭惡參數會給出完全不同的組合。理解 $\lambda$ 的角色,有助把「模型輸出」與「個人承受風險的意願」分開看待——前者是估計問題,後者無法由數據回答。
- 內容屬框架層面的導論,時效影響較小。 均值-方差框架自 1952 年沿用至今,屬基礎理論;但 SPO 一類「端到端」方法是近年才活躍的方向,截至 2026 年中的文獻仍在快速演進,有興趣深入者可留意最新研究動態。
名詞解釋
- 簡單回報 Simple Return:當期價格相對上期的百分比變化,衡量單期表現的基本單位
- 對數回報 Log Return:價格比率取自然對數的回報度量,具時間可加性,學術建模常用
- 預期回報 Expected Return:隨機回報的期望值,即回報分佈的一階矩
- 方差 Variance:隨機變數偏離其均值的平均平方距離,MVO 框架中的風險度量
- 協方差矩陣 Covariance Matrix:記錄多項資產回報兩兩共同變動程度的方陣,決定分散投資的風險縮減效果
- 均值-方差優化 Mean-Variance Optimization:Markowitz 提出的組合優化框架,在預期回報與組合方差之間取捨求最優權重
- 目標函數 Objective Function:優化問題中要被最大化或最小化的函數,MVO 中即風險調整後回報
常見問題 FAQ
為甚麼分析投資組合時看回報而不是價格?
價格的絕對水平因資產而異,無法直接比較;回報把價格變化標準化為百分比,不同資產的表現才能放在同一尺度上聚合與比較。此外,回報序列的統計性質通常比價格序列更適合建模。
均值-方差優化中的 $\lambda$ 應該怎樣設定?
$\lambda$ 代表風險厭惡程度,數值愈大,最優組合愈保守。它並非由數據估計出來的參數,而是反映決策者主觀偏好的選擇,實務上常透過掃描多個 $\lambda$ 值、觀察組合的風險回報特性來決定。
預測回報越準,投資組合表現就越好嗎?
不一定。傳統兩階段框架中,預測環節追求統計準確度,與最終決策品質並不直接掛鈎——某些方向上高估回報可能不影響配置,另一些方向的小誤差卻會令權重大幅偏移。Smart Predict-then-Optimize 正是為了把預測目標與決策目標對齊而提出的研究方向。
協方差矩陣在組合管理中起甚麼作用?
協方差矩陣記錄資產回報之間的共同變動。組合方差 $\mathbf{w}^\top \Sigma \mathbf{w}$ 之所以不等於各資產方差的加權和,正是因為非對角線的協方差項:資產之間相關性愈低,分散投資降低整體風險的效果愈明顯。
原影片
本文整理自以下影片,版權屬原創作者所有,建議配合原片觀看: