對數回報 Log Returns:量化研究偏好它的三個理由(補充講)|Quant Theory 第 33 講筆記
第 33 課・共 34 課
目錄
量化研究處理回報數據時,為何普遍選用對數回報 Log Returns 而非直觀的百分比回報?本講是 Quant Theory 系列的補充講,Liu Peng 用一條短片的篇幅,有系統地講解對數回報的定義、它與簡單回報的分別,並給出偏好對數回報的三個數學理由:可加性、對稱性,以及由凹函數性質引致的內在風險厭惡。本篇筆記按原片脈絡重構,公式推導完整保留。
學習重點
- 簡單回報 Simple Return 是價格變化除以前期價格;對數回報 Log Return 是對價格比率取對數,兩者可互相轉換
- 理由一:對數回報在時間維度可相加,多期複利效果由連乘化簡為累加,還原時只需取指數
- 理由二:價格先升後跌回原位時,兩期對數回報正好圍繞零點對稱,簡單回報則做不到
- 理由三:對數函數是凹函數,由詹森不等式可知,最大化累積對數回報的投資者內在地風險厭惡,同等預期回報下會偏好波動較低的資產
詳細筆記
由價格到回報:兩種定義
設資產在時間 $t$ 的價格為 $P_t$,下一期價格為 $P_{t+1}$。價格會上上落落,我們需要一個標準化的方法衡量每期表現。最直觀的做法是簡單回報 Simple Return,亦即百分比回報:先計算價格差額(可正可負),再除以前一期價格作正規化:
$$R_{t+1} = \frac{P_{t+1} - P_t}{P_t}$$講者接着引入對數回報 Log Return:同樣取兩期價格的比率,但再施加對數變換:
$$r_{t+1} = \ln\!\left(\frac{P_{t+1}}{P_t}\right)$$利用對數函數的基本性質 $\ln(A/B) = \ln A - \ln B$,上式可以改寫為兩個對數價格之差:
$$r_{t+1} = \ln P_{t+1} - \ln P_t$$這個「對數價格差」的寫法在日後處理時間序列時非常有用。以一個數字例子對照兩者:價格由 100 升至 105,簡單回報是 $5%$,對數回報則是 $\ln(105/100) \approx 4.88%$——單期數值接近但並不相等,回報幅度愈大差距愈明顯。講者強調,定義本身不複雜,重點在於為何量化界偏好它——以下三個理由才是本講主體。
理由一:可加性令複利計算大幅化簡
第一個理由是:對數回報在時間維度上可相加(additive),因此特別適合建模金融資產隨時間的複利效應 Compounding Effect。
先看用簡單回報計算多期累積回報要做甚麼。每期回報必須先轉成 $1+R$ 格式,然後逐期連乘:
$$\text{累積回報} = (1+R_1)(1+R_2)\cdots(1+R_T) - 1$$講者指出,這個做法本質上要把每一期的單期回報加一之後全部乘起來,處理長序列時既繁瑣又不便做統計分析。
改用對數回報之後,同一件事變成直接相加:
$$r_1 + r_2 + \cdots + r_T$$為何加法等同於連乘?講者把數式展開驗證。假設由第 0 期開始:
$$r_1 + r_2 + \cdots = \ln\frac{P_1}{P_0} + \ln\frac{P_2}{P_1} + \cdots = \ln\!\left(\frac{P_1}{P_0}\cdot\frac{P_2}{P_1}\cdots\right) = \ln\frac{P_T}{P_0}$$中間所有價格項逐項對銷,最後只剩下首尾兩個價格的比率。用求和符號寫得更簡潔:
$$\sum_{t=1}^{T} r_t = \ln\frac{P_T}{P_0}$$那麼,兩種算法是否等價?講者說明:只要把累積對數回報取指數,就能還原成 $1+R$ 格式的累乘結果:
$$\exp\!\left(\sum_{t=1}^{T} r_t\right) = \prod_{t=1}^{T}(1+R_t)$$換言之,對數回報把「連乘」換成「相加」,代價只是最後多一步取指數。這一步化簡的實際好處在於:加法對平均、方差等統計量的推導是線性的,多期累積對數回報的期望值就是各期期望值之和;若改用簡單回報連乘,各期之間的交叉項會令推導迅速變得複雜。這是量化模型大量採用對數回報的根本原因。
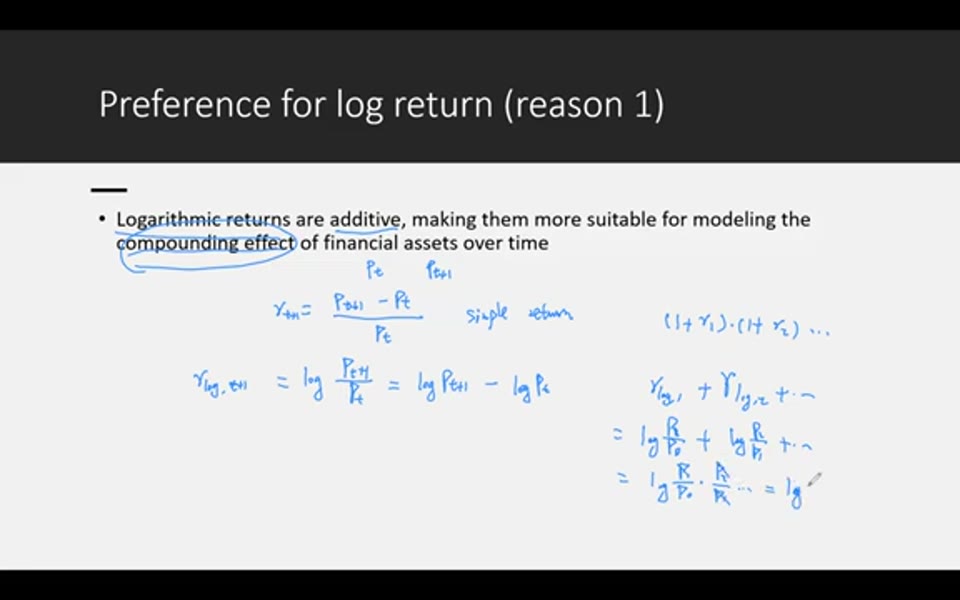 對數回報定義 $r_{t+1}=\ln(P_{t+1}/P_t)$,各期相加後中間項對銷,與 $(1+R_1)(1+R_2)\cdots$ 的連乘結果只相差一次指數運算。截圖出自原片(Liu Peng)
理由二:圍繞零點的對稱性
第二個理由是:與簡單回報相比,對數回報的分佈更圍繞零點對稱(symmetric around zero)。
講者用一個具體軌跡說明何謂對稱:價格由 $P_t$ 出發,下一期走到 $P_{t+1}$,再下一期回到 $P_t$。第一期的對數回報是:
$$r_{t+1} = \ln\frac{P_{t+1}}{P_t}$$第二期的對數回報則是:
$$r_{t+2} = \ln\frac{P_t}{P_{t+1}}$$講者證明這兩個數值正好互為負數。利用對數性質 $\ln(x^{-1}) = -\ln x$:
$$\ln\frac{P_t}{P_{t+1}} = \ln\!\left(\frac{P_{t+1}}{P_t}\right)^{-1} = -\ln\frac{P_{t+1}}{P_t}$$即 $r_{t+2} = -r_{t+1}$。價格升完跌回原位,兩期對數回報一正一負、絕對值相等,合計為零——這正是「圍繞零點對稱」的意思。
簡單回報就沒有這個性質。講者舉例:價格由 100 升至 105,再跌回 100。第一期簡單回報是 $+5\%$,第二期則是:
$$R = \frac{100 - 105}{105} \approx -4.76\% \neq -5\%$$負回報的絕對值較小,兩期相加不等於零。講者提醒,只要親手算一遍就會發現不對稱。簡單回報的「百分比分母效應」——上升和下跌用不同的起始價格作分母——令升跌幅度在百分比層面不再鏡像;對數變換正好吸收了這個不對稱。對稱性令對數回報的統計分佈更接近教科書假設(例如常態分佈),做推斷與建模時少一層顧慮。
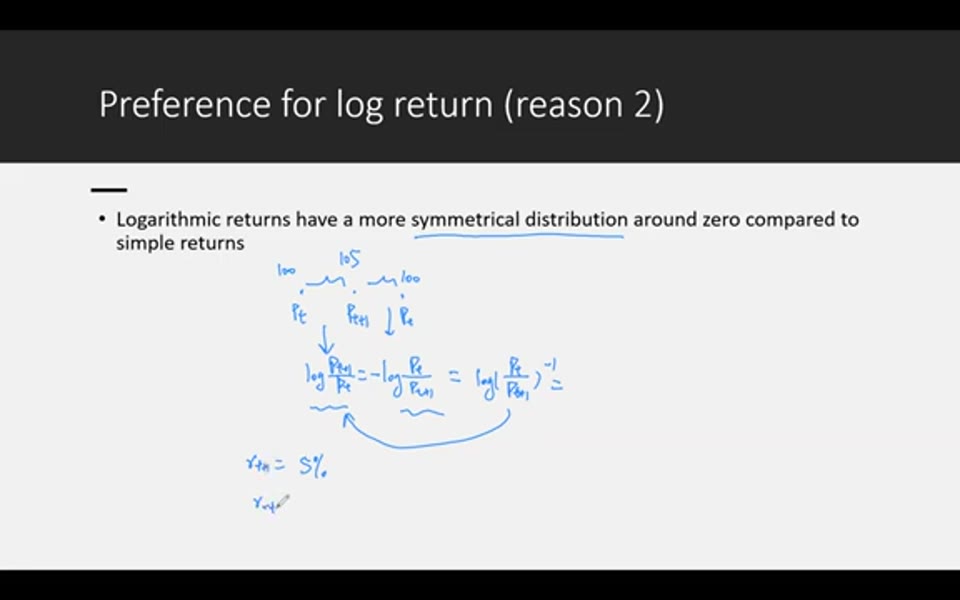 價格由 100 升至 105 再跌回 100,對數回報兩期互為負數、合計為零;簡單回報則是 $+5\%$ 與 $-4.76\%$,並不對稱。截圖出自原片(Liu Peng)
理由三:凹函數引致的內在風險厭惡
第三個理由涉及投資者的風險態度。講者的論點是:當我們以最大化累積對數回報為目標時,投資者(或代理人 agent)會內在地風險厭惡 Inherently Risk-Averse,即對風險比一般情況更敏感,而這源自對數函數的凹性(concavity)。
先看一個例子。資產甲的預期簡單回報是 5%、標準差 10%;資產乙同樣是預期回報 5%,但波動只有 5%。講者指出:若以對數回報作為衡量標準,投資者會偏好波動較低的資產乙;但若只看簡單回報的期望值,兩者期望值相同,顯示不出這種偏好。對數回報自帶「波動懲罰」,正是凹函數的後果。
數學上,對數函數的圖像向右延伸時愈來愈平,屬於凹函數。凹函數滿足詹森不等式 Jensen’s Inequality:函數的期望值不大於期望值的函數值:
$$E[f(X)] \leq f(E[X]) \quad (f \text{ 為凹函數})$$應用到回報上,先要做一步改寫。由對數回報的定義出發,把它表達為簡單回報的函數:
$$r_{t+1} = \ln\frac{P_{t+1}}{P_t} = \ln(1 + R_{t+1})$$這是因為 $P_{t+1}/P_t = 1 + (P_{t+1}-P_t)/P_t = 1 + R_{t+1}$。把 $f(x) = \ln x$、$X = 1+R$ 代入詹森不等式(此時簡單回報 $R$ 是隨機變數):
$$E\big[\ln(1+R)\big] \leq \ln\big(E[1+R]\big) = \ln\big(1 + E[R]\big)$$左方是期望對數回報,右方只取決於期望簡單回報。不等式告訴我們:期望簡單回報相同時,回報的隨機波動(方差)愈大,左方的期望對數回報就被壓得愈低。這就是「同等預期回報、偏好低波動」的數學根據。
講者再從圖像角度補充。以 $R$ 為橫軸、$\ln(1+R)$ 為縱軸(原點處 $R=0$、$\ln 1 = 0$):
- 在 $R$ 很大(強烈正回報)的區域,曲線相當平坦,斜率接近零——$R$ 再上升,對數回報幾乎不動,額外升幅帶來的「獎賞」有限
- 在 $R$ 為負的區域,愈往左斜率愈陡——$R$ 稍為下跌,對數回報大幅下挫,虧損帶來的「懲罰」被放大
兩個區域的敏感度並不對稱:下行風險對目標函數的衝擊遠大於上行驚喜。講者總結,以對數回報為目標函數,本身就內含風險厭惡——投資者會自動對下行波動更加敏感,這正是量化策略設計中想要的效果。
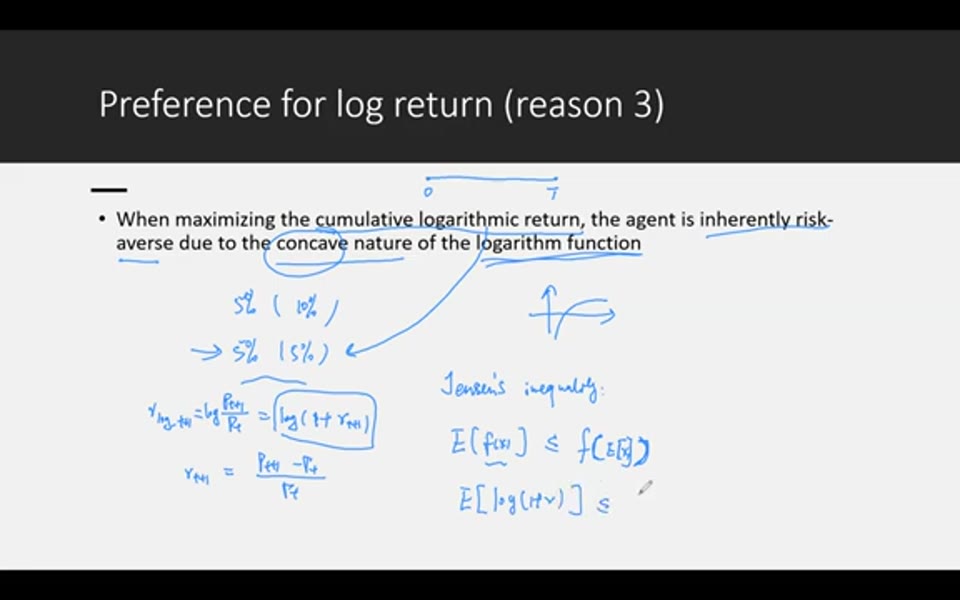 凹函數滿足 $E[f(X)]\leq f(E[X])$;代入 $f=\ln(1+\cdot)$ 後,波動愈大期望對數回報愈低,投資者因此內在地風險厭惡。截圖出自原片(Liu Peng)
🙏 覺得內容有用?本站所有內容免費提供,使用推薦碼開戶就是支持我們繼續營運的最大鼓勵:
ZA Bank 邀請碼 P20923
—— 你享 HKD 2,000 迎新獎賞,本站獲得營運支持。
立即開戶 →
(聯盟連結|投資涉及風險,受條款及細則約束,此資料僅可於香港境內分發)
欣利克的看法
- 「可加性」只限時間維度,橫切面不適用。對數回報沿時間相加沒有問題,但計算投資組合同一期的加權回報時,正確做法是對簡單回報取加權平均,對數回報並沒有這個橫切面性質。兩種回報各有適用場景,並非一方全面取代另一方,學員宜分清「時間方向用對數、截面方向用簡單」這條分工原則。
- 單期數值相近,但並不相等。回報幅度小的時候,$r \approx R$(因為 $\ln(1+R)\approx R$),所以日內或日線層面兩者差異有限;但回報幅度一大(例如單日升跌一成以上),兩者差距便不容忽視。常見誤區是直接把對數回報當成百分比向人滙報,正確做法是取指數還原成簡單回報再表達。
- 對稱性不等於分佈必然是常態。本講證明的是價格往返情境下兩期回報互為負數,這只是分佈形態較接近對稱的理據之一;真實市場的對數回報仍有厚尾、偏態等特徵,不宜因為「較對稱」就假設常態分佈成立,做風險度量時仍要檢驗實際數據。
- 風險厭惡是目標函數的內含屬性,不是對市場的預測。第三個理由講的是:選用對數回報作為優化目標,等於替模型內建了風險厭惡傾向。這是建模選擇的後果,與市場未來走勢無關,也不構成任何資產取態建議。不同文獻對效用函數的選取各有假設,讀者可比較後再判斷哪種適合自己的研究場景。
名詞解釋
- 對數回報 Log Return:取價格比率自然對數的回報算法,具時間可加性,多期累積只需相加
- 簡單回報 Simple Return:價格變化除以前期價格的百分比回報,單期直觀但多期須連乘
- 複利 Compounding:每期回報連本帶利滾存再投資,多期回報以累乘計算的機制
- 詹森不等式 Jensen’s Inequality:凹函數的期望值不大於期望值的函數值,是對數回報內含風險厭惡的數學基礎
- 波幅 Volatility:回報序列的離散程度,通常以標準差量度,本講中作為比較兩項資產的風險指標
- 預期回報 Expected Return:隨機回報變數的概率加權平均值,詹森不等式推導中的關鍵輸入
常見問題 FAQ
對數回報和簡單回報何時該用哪一個?
講者的建議脈絡是:涉及多期累積、時間序列建模與統計推導時用對數回報,因為加法運算遠比連乘方便;涉及單期表達或投資組合橫切面加權時用簡單回報,因為組合回報等於各資產簡單回報的加權平均,對數回報沒有這個性質。
對數回報算出來之後,如何還原成實際百分比回報?
單期而言,$R = e^{r} - 1$;多期而言,先將各期對數回報相加,再取指數減一,即 $\exp(\sum_t r_t) - 1$,結果與簡單回報的連乘算法完全一致。
為何對數回報目標會令投資者風險厭惡?
因為 $\ln(1+R)$ 是凹函數,由詹森不等式可知 $E[\ln(1+R)] \leq \ln(1+E[R])$:預期簡單回報相同時,回報波動愈大,期望對數回報愈低。加上負回報區域曲線陡峭、正回報區域平坦,虧損的懲罰大於盈利的獎賞,最大化對數回報自然等於迴避高波動。
兩期簡單回報 $+5\%$ 和 $-4.76\%$ 為何不對稱?
因為簡單回報的分母是各期自己的起始價格:由 100 升至 105 用 100 作分母得 $+5\%$,由 105 跌回 100 用 105 作分母只得約 $-4.76\%$。分母不同導致升跌幅度不對稱;對數回報取比率後再取對數,利用 $\ln(x^{-1}) = -\ln x$ 的性質,正好消除了這個不對稱。
原影片
本文整理自以下影片,版權屬原創作者所有,建議配合原片觀看: